using Roots
using ProjectRoot  # @projectroot: paths from the repository root
using NonlinearSolve
using Optim
using Optimization
import OptimizationNLopt
import NLopt
using JuMP
using Ipopt
using Plots
using LaTeXStrings1 非線形最適化
Nonlinear Optimization
経済モデルを数値的に解く作業は, 多くの場合「非線形方程式 \(f(\mathbf{x}) = \mathbf{0}\) を解く」か「非線形関数を最大化・最小化する」のどちらかに帰着します. 両者は表裏一体です. 最大化問題は一階条件を導出すれば方程式として解けますし, 最適化アルゴリズムの多くは方程式の解法の analogy として理解できます. 本章では, 前半で非線形方程式の解法である求根法 (root finding) を, 後半で目的関数を直接扱う非線形最適化 (nonlinear optimization) を解説します.
1.1 求根法
モデルを解く際に, \(f(\mathbf{x}) = \mathbf{0}\) となるような \(\mathbf{x}\) を求める必要があることが多いです. 例えば, 家計の最大化問題を解く際の一階条件は, 一般に非線形方程式の形をとります. ごく特殊なケースを除いて, 解析的に解くことができないため, 数値的に解を求める必要があります. この様な非線形方程式の数値解法は, 一変数の場合と多変数の場合に分けられます. 以下では, それぞれの方法について解説します.
1.1.1 一変数の非線形方程式
ここでは例として, 次のようなCRRA効用関数を用いた家計の最大化問題を考えてみましょう. \[ \max_{c, l} \frac{c^{1-\gamma_c}}{1-\gamma_c} + \alpha_l \frac{l^{1-\gamma_l}}{1-\gamma_l} \quad \text{s.t.} \quad c = w (1-l) \tag{1.1}\] この問題は以下の一階条件の解を求めることで解くことができます. \[ w^{1-\gamma_c} (1-l)^{-\gamma_c} - \alpha_l l^{-\gamma_l} = 0. \]
foc(l; w=1.0, γ_c=1.5, α_l=1.2, γ_l=1.5) =
    w^(1 - γ_c) * (1 - l)^(-γ_c) - α_l * l^(-γ_l)
これを図で表すと 図 1.1 のようになります. 求めたいのは, この関数と \(y = 0\) の交点の値です.
Code
plot(0.1:0.01:0.9, foc, label=false, lw=2)
hline!([0.0], ls=:dash, lw=2, label=false, color=:black)この様な一変数の非線形方程式 \(f(x) = 0\) の解法として, 以下の2つの選択肢があります.
- Non-bracketing method: 初期値 \(x_0\) からスタートして, \(f(x_n)\) が十分0に近づくまで反復的に計算. (ニュートン法など)
- Bracketing method: 区間 \([a, b]\) を選び, 区間を狭めていくことで解を求める. (二分法など)
一般に, Non-bracketing method は収束が速い代わりにその収束は保証されません. 一方で, Bracketing method は収束がわずかに遅い代わりに, 解が存在する区間を保証することができます. 以下では, その理由とそれぞれの適した利用場面を解説します.
Non-bracketing method
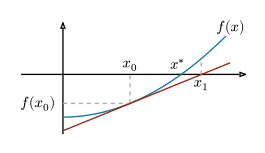
Non-bracketing method は基本的には一階微分を利用し, 初期値 \(x_0\) からスタートして反復的に解を求めます. ここでは, 最も古典的で簡単なニュートン法を紹介します.
アルゴリズム 1.1 (ニュートン法)
- 初期値 \(x_0\) を選ぶ. また停止条件として十分小さい \(\epsilon > 0\) を選ぶ.
- \(x_{n+1} = x_n - \frac{f(x_n)}{f'(x_n)}\) を計算する.
- \(|f(x_{n+1})| < \epsilon\) ならば停止し, \(x_{n+1}\) を解として返す. そうでなければ, \(n \leftarrow n+1\) として2に戻る.
dfoc(l; w=1.0, γ_c=1.5, α_l=1.2, γ_l=1.5) =
    w^(1 - γ_c) * γ_c * (1 - l)^(-γ_c - 1) + α_l * γ_l * l^(-γ_l - 1)

find_zero((foc, dfoc), 0.5, Roots.Newton())0.530349570343484実際に foc の上でニュートン法が収束していく様子を見てみましょう. 初期値を \(x_0 = 0.15\) とし, スライダー (Iteration \(N\)) を動かすと, 各反復での接線 (赤) が引かれ, その \(x\) 切片が次の点 \(x_{N+1}\) になります. 接線が急な最初の一歩で大きく動き, 数回の反復で根 (灰色の破線) に急速に近づく様子が確認できます.
ニュートン法は解の近くでは反復ごとに有効数字が倍増する2次収束を示し, わずか数回で高精度の解に達します. 一方で, 導関数 \(f'\) がゼロに近い点や初期値が悪い場合には反復が定義域の外に飛び出して発散することもあり, 収束は保証されません.
Hybrid method
JuliaのRoots.jlのデフォルトのNon-bracketing method (Order0())は, 厳密にはBracketing methodも一部利用します. また一階微分も必要としないため, より汎用的に利用することができます. ただし, 収束が速く収束が保証されない性質はNon-bracketing methodと同じです.
l = find_zero(foc, 0.5)0.530349570343484定義域の変換
Non-bracketing method では, \(x_{n+1}\) の値を更新する際に, 必ずしも \(x_{n+1}\) が定義域内にあることが保証されません. 例えば, 今回の例では 余暇時間ですので, \(l \in (0, 1)\) ですが, 初期値や関数形によっては, \(l < 0\) や \(l > 1\) となる可能性があります.
この場合, 端点解が存在するかどうかを確認する必要があります. 端点解が想定される場合は, 次節で説明するように Bracketing method を利用することが適しています. 今回の例では, 端点解が存在しないため (\(l = 0, 1\) のどちらにおいても効用が負の無限大に発散するため), Non-bracketing method での解の収束が保証されています. 以下の様な定義域の変換を用いることで, 解の収束を保証することができます.
注意 (定義域の変換). \(x\) が区間 \((a, b)\) で定義されるとき, 以下の変換を用いて定義域を \((-\infty, \infty)\) にすることができる. \[ x = \frac{a + b \exp y}{1 + \exp y} \] 明らかに, \(y \rightarrow -\infty\) のとき \(x \rightarrow a\), \(y \rightarrow \infty\) のとき \(x \rightarrow b\) となる.
今回の例では, \(l = \frac{1}{1 + \exp(-y)}\) (つまりシグモイド関数) という変換を用いることができます.
y = find_zero(y -> foc(1 / (1 + exp(-y))), 0.0)
l = 1 / (1 + exp(-y))0.530349570343484Bracketing method
Bracketing method は, 解が存在する区間 \([a, b]\) を選び, その区間を狭めていくことで解を求めます. ここでは最も基本的な二分法を用いることで解を求めることができます.
アルゴリズム 1.2 (二分法)
- 区間 \([a, b]\) を選ぶ. また停止条件として十分小さい \(\epsilon > 0\) を選ぶ.
- \(f(a) \cdot f(b) < 0\) ならば, \(c = \frac{a + b}{2}\) を計算する.
- \(|f(c)| < \epsilon\) ならば, \(c\) を解として返す. そうでなければ, \(f(a) \cdot f(c) < 0\) ならば, \(b \leftarrow c\) として2に戻る. そうでなければ, \(a \leftarrow c\) として2に戻る.
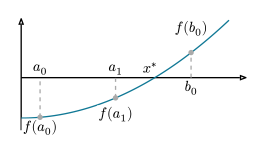
例えば, 今回の例では \(l \in (0, 1)\) ですので, \(l = 0\) と \(l = 1\) で効用が発散することから, 解が存在する区間は \((0, 1)\) です. なお, 端点でFOCが定義されてない場合も多いので, 端点より微小に内側の区間を選ぶことが多いです.
ϵ = 1e-9
l = find_zero(foc, (ϵ, 1 - ϵ))0.530349570343484二分法が区間を狭めていく様子も見てみましょう. 開始区間を \([a_0, b_0] = [0.4, 0.8]\) とし, スライダー (Iteration \(N\)) を動かすと, 中点 \(c_N\) での符号に応じて区間 (水色の帯) が半分ずつに狭まっていきます. ニュートン法と違い解は常に区間内に保証されますが, 区間幅は毎回半分になるだけなので, 同じ精度に達するにはより多くの反復が必要です.
二分法は各反復で区間幅がちょうど半分になる線形収束です. 収束は遅いものの, 初期区間の両端が異符号でありさえすれば必ず解に収束する頑健さが利点です.
端点解の存在
以下の様なカップルの意思決定問題を考えてみましょう. \[ \max_{c_m, c_f, l_m, l_f} u(c_m, l_m) + u(c_f, l_f) \tag{1.2}\] subject to \[ c_m + c_f = w_m (1 - l_m) + w_f (1 - l_f). \] 一階条件から以下の関係が導けます: \[ \frac{l_m}{l_f} = \left(\frac{w_f}{w_m}\right)^{\frac{1}{\gamma_l}}. \] この関係から一方の相対賃金が十分に大きい場合, 例えば \(w_m \gg w_f\) の場合, \(l_f > 1\) となる可能性があります (\(l_m\) は余暇時間のため, 0よりある程度大きい値をとるということが想像できます.) 内点解が存在する場合の \(l_f\) に関する一階条件は以下のようになります. \[ w_m\left(1-\left(\frac{w_f}{w_m}\right)^{\frac{1}{\gamma_l}}l_f\right) + w_f(1-l_f) - 2\left(\frac{w_f}{\alpha_l}\right)^{\frac{1}{\gamma_c}}l_f^{\frac{\gamma_l}{\gamma_c}} = 0. \]
Code
function foc_bargaining(l_f; w_m=1.0, w_f=0.5, γ_c=1.5, α_l=1.2, γ_l=1.5)
    return w_m * (1 - (w_f / w_m)^(1 / γ_l) * l_f) + w_f * (1 - l_f) -
           2 * (w_f / α_l)^(1 / γ_c) * l_f^(γ_l / γ_c)
end

lf_grid = 0.01:0.01:0.99
cols = [mypalette[6], mypalette[2], mypalette[4]]
p = plot(xlabel=L"l_f", legend=false, xlims=(0.0, 1.13))
for (i, wf) in enumerate([1.0, 0.5, 0.1])
    ys = foc_bargaining.(lf_grid; w_f=wf)
    plot!(p, lf_grid, ys, lw=2, color=cols[i])
    # direct label at the right end of each line
    annotate!(p, 1.0, ys[end], text(L"w_f = %$wf", 9, :black, :left))
end
hline!(p, [0.0], ls=:dash, lw=2, label=false, color=:black)
pまた, \(l_f = 1\) における一階条件は以下のようになります. \[ w_m(1-l_m) - 2\left(\frac{w_m}{\alpha_l}\right)^{\frac{1}{\gamma_c}} l_m^{\frac{\gamma_l}{\gamma_c}} = 0. \] この様な場合, Bracketing method の考えが有効です.
- 端点 \(l_f = 0, 1\) (実用上は \(\epsilon, 1-\epsilon\)) において, 一階条件の値を計算.
- 一階条件の値が異符号であれば, 二分法を用いて解を求める.
- 一階条件の値が同符号であれば, 端点解 (この場合, \(l_f = 1\)) 上の解を求める.
function solve_bargaining(; w_m=1.0, w_f=0.5, γ_c=1.5, α_l=1.2, γ_l=1.5)

    ϵ = 1e-9
    left = w_m * (1 - (w_f / w_m)^(1 / γ_l) * ϵ) + w_f * (1 - ϵ) -
           2 * (w_f / α_l)^(1 / γ_c) * ϵ^(γ_l / γ_c)
    right = w_m * (1 - (w_f / w_m)^(1 / γ_l) * (1 - ϵ)) + w_f * ϵ -
            2 * (w_f / α_l)^(1 / γ_c) * (1 - ϵ)^(γ_l / γ_c)

    if left * right < 0
        l_f = find_zero(
            l_f -> w_m * (1 - (w_f / w_m)^(1 / γ_l) * l_f) + w_f * (1 - l_f) -
                   2 * (w_f / α_l)^(1 / γ_c) * l_f^(γ_l / γ_c),
            (ϵ, 1 - ϵ))
        l_m = (w_f / w_m)^(1 / γ_l) * l_f
    else
        l_f = 1.0
        x = find_zero(
            x -> w_m * (1 - 1 / (1 + exp(x))) -
                 2 * (w_m / α_l)^(1 / γ_c) * (1 / (1 + exp(x)))^(γ_l / γ_c),
            0.0)
        l_m = 1 / (1 + exp(x))
    end

    c = w_m * (1 - l_m) + w_f * (1 - l_f)
    c_m = 0.5 * c
    c_f = 0.5 * c
    U = (c_m^(1 - γ_c) / (1 - γ_c)) + α_l * (l_m^(1 - γ_l) / (1 - γ_l)) +
        (c_f^(1 - γ_c) / (1 - γ_c)) + α_l * (l_f^(1 - γ_l) / (1 - γ_l))
    return (c_m=c_m, c_f=c_f, l_m=l_m, l_f=l_f, U=U)
end
Code
wf_grid = 0.1:0.01:0.9
lm = [solve_bargaining(w_f=w).l_m for w in wf_grid]
lf = [solve_bargaining(w_f=w).l_f for w in wf_grid]
p = plot(xlabel=L"w_f", legend=false, xlims=(0.1, 1.0))
plot!(p, wf_grid, lm, lw=2, color=mypalette[6])
plot!(p, wf_grid, lf, lw=2, color=mypalette[2])
# direct labels at the right end (nudged apart since the lines converge there)
annotate!(p, 0.915, lm[end] - 0.02, text(L"l_m", 9, :black, :left))
annotate!(p, 0.915, lf[end] + 0.02, text(L"l_f", 9, :black, :left))
p1.1.2 多変数の非線形方程式
多変数の非線形方程式では Bracketing method は使えず, ニュートン法のような Non-bracketing method を用いる必要があります. そのため内点解と微分可能な関数を仮定しており, 端点解やスムースでない関数が想定される場合は使えません. そのような場合は, 原始的なグリッドサーチを用いるか, 後述するように非線形最適化問題として解く必要があります.
なお, 多くの標準的な効用関数 (CRRA, CESなど) の場合, 一階条件は一変数の非線形方程式に帰着できます. 基本的には, 一変数の非線形方程式の方が収束が速く, 端点解の存在を確認しやすいので, 可能な場合は一変数の非線形方程式に帰着させることが望ましいです. 今回は学習のために, 式 1.1 を3変数 (\(c\), \(l\), \(\lambda\)) の非線形方程式 1.3 として解いてみましょう. NonlinearSolve.jl を用いると便利です. \[ \begin{aligned} c^{-\gamma_c} &= \lambda \\ \alpha_l l^{-\gamma_l} &= \lambda w \\ c &= w(1-l) \end{aligned} \tag{1.3}\]
function solve_nonlinear_system(; w=1.0, γ_c=1.5, α_l=1.2, γ_l=1.5)
    f((c, l, λ), par) = [
        λ * c^γ_c - 1,
        α_l - λ * w * l^γ_l,
        c - w * (1 - l)
    ]
    prob = NonlinearProblem(f, [0.5, 0.5, 0.35], 0.)
    sol = solve(prob, NewtonRaphson())

    return (c=sol.u[1], l=sol.u[2], λ=sol.u[3])
end

solve_nonlinear_system()
(c = 0.469650429656516, l = 0.530349570343484, λ = 3.1069761107915044)工夫として負の指数を避けるように式変形しています. これは最適化の際に, 負の数の負の数乗によってエラーが起きることを避けるためです.
1.2 一変数の非線形最適化
ここからは, 非線形最適化の方法について解説します. 基本的には, 次の非線形関数 \(f(\cdot)\) の最小化問題を考えます. \[ \min_{\mathbf{x} \in \mathcal{X}} f(\mathbf{x}). \] 制約条件として, \(g(\mathbf{x}) = \mathbf{0}\) や \(h(\mathbf{x}) \leq \mathbf{0}\) を課すこともできますが, まずは制約なしの最適化問題を考えます. 制約付きの最適化問題については1.4節で解説します.
一変数の非線形最適化は, 1.1節で解説した, ニュートン法と二分法の analogy である, 準ニュートン法 (Quasi-Newton method) と 黄金分割法 (Golden-section search) で解くことができます. これらの方法は, それぞれニュートン法と二分法のように, 収束の速さと保証のトレードオフがあります. 準ニュートン法は, 収束が速い代わりに, 解が存在する保証がありません. 一方で, 黄金分割法は, 収束が遅い代わりに, 解が存在する区間を保証することができます.
1.2.1 準ニュートン法
求根法のニュートン法では, \(f(x) = 0\) を解くために \(x_{n+1} = x_n - f(x_n) / f'(x_n)\) という更新式を用いました. 最適化問題 \(\min_x f(x)\) では, 一階条件 \(f'(x) = 0\) を解くことが目標ですので, ニュートン法を \(f'(x) = 0\) に適用すると, 以下のアルゴリズムが得られます.
アルゴリズム 1.3 (ニュートン法 (1変数))
- 初期値 \(x_0\) を選ぶ. 停止条件として十分小さい \(\epsilon > 0\) を選ぶ.
- \(x_{n+1} = x_n - \frac{f'(x_n)}{f''(x_n)}\) を計算する.
- \(|f'(x_{n+1})| < \epsilon\) ならば停止し, \(x_{n+1}\) を解として返す. そうでなければ, \(n \leftarrow n+1\) として2に戻る.
二階微分 \(f''(x_n)\) の計算が困難な場合, これを近似する方法が準ニュートン法 (Quasi-Newton method) です. 代表的な方法として BFGS法 があり, 一階微分の情報のみを用いて二階微分 (ヘッセ行列) を逐次的に近似します.
1.1節で用いた CRRA 効用関数の最大化問題 (式 1.1) を例にとりましょう. 制約を代入すると, 以下の一変数最大化問題になります. \[ \max_l v(l) = \frac{(w(1-l))^{1-\gamma_c}}{1-\gamma_c} + \alpha_l \frac{l^{1-\gamma_l}}{1-\gamma_l}. \]
v(l; w=1.0, γ_c=1.5, α_l=1.2, γ_l=1.5) =
    (w * (1 - l))^(1 - γ_c) / (1 - γ_c) + α_l * l^(1 - γ_l) / (1 - γ_l)
Optim.jl の BFGS() を用いて解くことができます. BFGS() は多変数関数に対応する手法であるため, 一変数であってもベクトルの形で表現する必要があります. また, Optim.jl は最小化を行うため, 目的関数の符号を反転させます. なお, \(l \in (0, 1)\) の制約を考慮するために Fminbox を用います.1
ϵ = 1e-9
result = optimize(l -> -v(l[1]), [ϵ], [1.0 - ϵ], [0.5], Fminbox(BFGS()))
result.minimizer[1]0.530349570336863求根法のニュートン法と同様に, 初期値の選び方によっては収束しない場合があり, 大域的な最適解への収束は保証されません.
数値微分
ニュートン法系のアルゴリズムは, 一階微分や二階微分を必要とします. 解析的に導関数が分かっている場合は, それを勾配として optimize() に渡すことでより高速に解くことができます. 解析的に分からない場合は導関数を数値的に求めますが, その方法 (有限差分・複素ステップ・自動微分) は2.2節で扱います. Optim.jl は勾配を指定しなければ自動微分などで勾配を計算します.
デフォルトの設定
Optim.optimize() では, メソッドを指定せず区間も指定しない場合は, デフォルトでは Nelder-Mead法 が用いられます (NelderMead()). これは導関数を必要としない最適化アルゴリズムです. また, 勾配を指定した場合でも, BFGS法のメモリ使用量を改善した L-BFGS法 (LBFGS()) が用いられます.
1.2.2 黄金分割法
二分法が区間 \([a, b]\) において \(f(a) \cdot f(b) < 0\) (中間値の定理) を利用して区間を半分に分割していくのに対し, 黄金分割法は関数が区間内で単峰 (unimodal) であること, すなわち極値が一つだけ存在することを仮定し, 黄金比を用いて区間を縮小していきます.
アルゴリズム 1.4 (黄金分割法) 最小化問題 \(\min_{x \in [a, b]} f(x)\) を解く. 黄金比を \(\varphi = \frac{\sqrt{5}-1}{2} \approx 0.618\) とする.
- 区間 \([a, b]\) を選ぶ. 停止条件として十分小さい \(\epsilon > 0\) を選ぶ.
- 内分点 \(x_1 = a + (1-\varphi)(b-a)\), \(x_2 = a + \varphi(b-a)\) を計算する.
- \(f(x_1) \leq f(x_2)\) ならば \(b \leftarrow x_2\) とし, そうでなければ \(a \leftarrow x_1\) とする.
- \(|b - a| < \epsilon\) ならば停止し, \(\frac{a+b}{2}\) を解として返す. そうでなければ, 2に戻る.
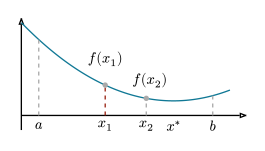
図 1.6 は単峰関数 \(f\) に対する黄金分割法の一ステップを表しています. 内分点 \(x_1, x_2\) で関数値を比較し, \(f(x_1) > f(x_2)\) であるため極小値は \(x_1\) より右側にあると判断でき, 区間の左端を \(a \leftarrow x_1\) (赤い破線) に更新して探索区間を縮小します.
各ステップで区間が \(\varphi \approx 0.618\) 倍に縮小されるため, 単峰関数であれば収束が保証されます. なぜ内分比に黄金比を取るのかについては, A.1節で証明します. ただし, 準ニュートン法と比較すると収束速度は遅くなります (線形収束). Optim.jl の GoldenSection() を用いて解くことができます (NonlinearSolve.jl も同名の関数をエクスポートしているため, Optim.GoldenSection() と修飾して呼びます).
ϵ = 1e-9
result = optimize(l -> -v(l), ϵ, 1 - ϵ, Optim.GoldenSection())
result.minimizer0.5303495600624788二分法と同様に, 適切な区間を指定すれば収束が保証されるため, 準ニュートン法よりも堅牢な方法です.
デフォルトの設定
Optim.optimize() では, メソッドを指定せずに区間を指定した場合は, デフォルトでは黄金分割法を改良した Brent法 が用いられます (Brent()).
1.3 多変数の非線形最適化
1.3.1 単純なケース
一変数の場合と同様に, 多変数関数 \(f: \mathbb{R}^n \to \mathbb{R}\) の最小化も, 一階条件 \(\nabla f(\mathbf{x}) = \mathbf{0}\) を解く問題として捉えられます. これは1.1節の多変数求根法を最適化に応用したものです. ニュートン法は, ヤコビアンの代わりにヘッセ行列 \(\nabla^2 f\) を用いて更新します.
アルゴリズム 1.5 (ニュートン法 (多変数))
- 初期値 \(\mathbf{x}_0\) を選ぶ. 停止条件として十分小さい \(\epsilon > 0\) を選ぶ.
- \(\mathbf{x}_{n+1} = \mathbf{x}_n - \left[\nabla^2 f(\mathbf{x}_n)\right]^{-1} \nabla f(\mathbf{x}_n)\) を計算する.
- \(\|\nabla f(\mathbf{x}_{n+1})\| < \epsilon\) ならば停止する. そうでなければ \(n \leftarrow n+1\) として2に戻る.
目的関数が滑らかで局所最適点が1つしかない場合は, 初期値の近傍を下っていく局所的手法 (local method) だけで大域的最適点に到達できます. 一変数の場合と同様, ヘッセ行列とその逆行列の計算は高コストなため, 実際には準ニュートン法 (BFGS) が広く使われます. BFGS はヘッセ行列 (今度は \(n \times n\) 行列) を一階微分の履歴から逐次的に近似します. 勾配すら利用できない場合は, 導関数を必要としない Nelder-Mead 法 (単体法) が使えます.
例として, 資本 \(k\) と労働 \(l\) を投入する企業の利潤最大化を考えます. \[ \max_{k, l} \pi(k, l) = k^\alpha l^\nu - r k - w l, \qquad \alpha + \nu < 1. \] 一階条件は「限界生産物 = 要素価格」, すなわち \(\alpha k^{\alpha-1} l^\nu = r\) と \(\nu k^\alpha l^{\nu-1} = w\) です.
profit(k, l; α=0.3, ν=0.5, r=0.1, w=1.0) = k^α * l^ν - r * k - w * l\(k, l > 0\) の正値制約を満たすため, 対数をとった変数 \((\log k, \log l)\) について最適化します.2 Optim.jl の BFGS() と, 導関数を使わない NelderMead() の両方で解いてみましょう.
obj(a) = -profit(exp(a[1]), exp(a[2]))
res_bfgs = optimize(obj, [0.0, 0.0], BFGS())
res_nm = optimize(obj, [0.0, 0.0], NelderMead())
println("BFGS:        ", round.(exp.(Optim.minimizer(res_bfgs)), digits=4))
println("Nelder-Mead: ", round.(exp.(Optim.minimizer(res_nm)), digits=4))
BFGS: [2.7557, 0.4593]
Nelder-Mead: [2.7553, 0.4592]どちらも同じ最適点 \((k, l) \approx (2.76, 0.46)\) に収束します.
1.3.2 複雑なケース
単純なケースでは, どの初期値から出発しても同じ最適点に収束しました. これは目的関数が (対数変換の後に) 凸で, 局所最適点がただ1つだったからです. しかし, 構造推定の目的関数 (SMM や GMM の目的関数など) をはじめ, 多くの経済モデルの目的関数は多峰性 (multimodal, 非凸) をもつ可能性があり, 局所最適点が複数存在する場合があります. このとき最適化法は2種類に大別されます.
- 局所的手法 (local method): 初期値の近くの谷を下っていく. BFGS や Nelder-Mead はこれにあたり, 収束は速いが, たどり着く最適点は初期値に依存する. 悪い初期値では, 大域的最適点でない局所最適点に捕まる.
- 大域的手法 (global method): 定義域全体を系統的 (あるいは確率的) に探索し, 大域的最適点を探す. 探索範囲 (box 制約) を指定する必要があり, 一般に局所的手法より多くの関数評価を要する.
大域的手法を数多く備えた代表的なライブラリが NLopt です. Julia では Optimization.jl が, NLopt を含む多くのソルバーを共通のインターフェースで扱えます. 問題を OptimizationProblem として組み立て, ソルバー (例えば NLopt の NLopt.GN_DIRECT_L()) を指定して solve するだけです. 以下ではこの Optimization.jl 経由で NLopt を呼びます.3
多峰性の例として, 多数の局所最適点をもつ Rastrigin 関数を最小化します. \[ f(\mathbf{x}) = 10 n + \sum_{i=1}^{n} \left[ x_i^2 - 10 \cos\left(2\pi x_i\right) \right], \qquad \mathbf{x} \in [-5.12, 5.12]^n. \] 放物線 \(\sum_i x_i^2\) に余弦波の細かい起伏を重ねた関数で, 定義域の至る所に局所最適点をもちます. 大域的最適点は原点 \(\mathbf{x} = \mathbf{0}\) で, そこで \(f = 0\) です. 以下では \(n = 2\) とします.
rastrigin(x) = 10 * length(x) + sum(x .^ 2 .- 10 .* cos.(2π .* x))図 1.7 にこの関数の形状を示します. 放物線状のなだらかな椀の上に細かい起伏が重なり, 至る所に局所最適点 (谷) があるのが分かります.
Code
xs = range(-5.12, 5.12, length=150)
Z = [rastrigin([x, y]) for y in xs, x in xs]
surface(xs, xs, Z, c=:inferno, xlabel=L"x_1", ylabel=L"x_2",
zlabel=L"f(\mathbf{x})", colorbar=false, camera=(35, 40), size=(560, 440))まず, 単純なケースでも使った局所的手法 (Nelder-Mead) を, 原点から離れた初期値 \([3, 3]\) から走らせます.
res_local = optimize(rastrigin, [3.0, 3.0], NelderMead())
(x=round.(Optim.minimizer(res_local), digits=3),
    f=round(Optim.minimum(res_local), digits=3))
(x = [2.985, 2.985], f = 17.909)局所最適点 \((2.98, 2.98)\) に捕まり, \(f \approx 17.9\) と大域的最適値 \(0\) から大きく外れています. 初期値を原点の近くにとれば \(f = 0\) に収束しますが, どの谷に落ちるかは初期値次第です.
次に, NLopt の大域的手法 DIRECT-L で探索範囲 \([-5.12, 5.12]^2\) 全体を探索します. Optimization.jl では目的関数を f(u, p) の形 (u が変数, p がパラメータ) で与え, 探索範囲を lb / ub で指定します.
optf = OptimizationFunction((u, p) -> rastrigin(u))
prob = OptimizationProblem(optf, [3.0, 3.0]; lb=[-5.12, -5.12], ub=[5.12, 5.12])
sol = solve(prob, NLopt.GN_DIRECT_L(), maxiters=5000)
(x=round.(sol.u, digits=3), f=round(sol.objective, digits=3))
(x = [0.0, 0.0], f = 0.0)初期値によらず大域的最適点 \(\mathbf{x} = \mathbf{0}\) (\(f = 0\)) にたどり着きます. DIRECT (DIviding RECTangles) は探索範囲を系統的に分割していく決定論的な手法で, 初期値の値には依存しません.
実務では, 大域的手法で有望な領域を絞り込んでから局所的手法で精密化する, という組み合わせがよく使われます. NLopt の MLSL (Multi-Level Single-Linkage, :G_MLSL_LDS) は, 定義域全体から多数の初期値をサンプルして局所的手法を繰り返し適用する multistart 法で, この考えを体系化したものです.
1.4 制約付き非線形最適化
経済モデルでは, 予算制約などの制約付き最適化が中心的です. 一般に, 等式制約 \(g(\mathbf{x}) = \mathbf{0}\) と不等式制約 \(h(\mathbf{x}) \leq \mathbf{0}\) のもとで \(f(\mathbf{x})\) を最小化する問題を考えます. ラグランジュ関数 \[ \mathcal{L}(\mathbf{x}, \lambda, \mu) = f(\mathbf{x}) - \lambda^\top g(\mathbf{x}) - \mu^\top h(\mathbf{x}) \] の停留点を KKT 条件のもとで求める, というのが基本的な考え方です. 数値的には主に3つのアプローチがあります.
変数消去. 等式制約を代入して未知数を減らし, 制約なし問題に帰着させる方法です. 一変数の例で予算制約 \(c = w(1-l)\) を代入したのがこれにあたります. 2財の消費者問題を例にとりましょう. \[ \max_{c_1, c_2} c_1^a c_2^b \quad \text{s.t.} \quad p_1 c_1 + p_2 c_2 = m. \] 予算制約から \(c_2 = (m - p_1 c_1)/p_2\) を代入すれば, \(c_1\) のみの一変数問題になります.
p1, p2, m = 1.0, 2.0, 10.0
u2(c1; a=0.4, b=0.6) = c1^a * ((m - p1 * c1) / p2)^b
res = optimize(c1 -> -u2(c1), 1e-6, m / p1 - 1e-6, Optim.GoldenSection())
c1 = Optim.minimizer(res)
(c1=c1, c2=(m - p1 * c1) / p2)
(c1 = 3.9999999973978277, c2 = 3.0000000013010863)コブ・ダグラス型の需要 \(c_1 = a m / p_1 = 4\), \(c_2 = b m / p_2 = 3\) と一致します.
箱制約. \(0 \leq c \leq \bar{c}\) のような単純な上下限 (box constraint) は, ソルバーに下限 lb と上限 ub を渡すだけで直接扱えます. 変数消去した消費者問題を, 導関数を使わない NLopt の BOBYQA 法で解いてみましょう.
negu(c1, p) = -(c1[1]^0.4 * ((m - p1 * c1[1]) / p2)^0.6)
prob = OptimizationProblem(OptimizationFunction(negu), [2.0];
    lb=[1e-6], ub=[m / p1 - 1e-6])
sol = solve(prob, NLopt.LN_BOBYQA(), maxiters=10_000)
(c1=sol.u[1], c2=(m - p1 * sol.u[1]) / p2)
(c1 = 4.0000000167979515, c2 = 2.9999999916010243)変数消去と同じ解 \((c_1, c_2) = (4, 3)\) が得られます.
一般の制約. 変数消去が難しい一般の等式・不等式制約は, 制約関数を直接ソルバーに渡して扱います. 制約 \(g(\mathbf{x})\) を cons で, その下限・上限を lcons / ucons で与えます (等式制約は下限 = 上限). 予算制約 \(p_1 c_1 + p_2 c_2 = m\) を消去せずに, 制約を扱える NLopt の COBYLA 法で解いてみましょう.
negu2(c, p) = -(c[1]^0.4 * c[2]^0.6)
budget(res, c, p) = (res[1] = p1 * c[1] + p2 * c[2] - m)
optf = OptimizationFunction(negu2; cons=budget)
prob = OptimizationProblem(optf, [2.0, 4.0]; lcons=[0.0], ucons=[0.0],
    lb=[0.0, 0.0], ub=[50.0, 50.0])
sol = solve(prob, NLopt.LN_COBYLA(), maxiters=10_000)
sol.u
2-element Vector{Float64}:
4.0000000528577555
2.9999999735711227予算制約 \(p_1 c_1 + p_2 c_2 - m\) の下限・上限をともに \(0\) とすることで等式を表しています. 同じ解 \((c_1, c_2) = (4, 3)\) が得られます. NLopt には勾配を使う SLSQP など制約付き問題向けの手法も揃っており, 真の内点法が必要であれば次節の Ipopt を使います.
より複雑な制約付き問題では, 次に述べるように, 問題を宣言的に記述してソルバーに渡す方法が便利です.
1.5 Mathematical Programming
より強力な方法として, 解きたい最適化問題を直接ソルバーにかける方法があります. Juliaの場合は JuMP.jl が有名です. ここでは, 式 1.2 を JuMP を用いて解いてみましょう.
function solve_jump(; w_m=1.0, w_f=0.5, γ_c=1.5, α_l=1.2, γ_l=1.5)

    model = Model(Ipopt.Optimizer)
    set_silent(model)
    set_attribute(model, "print_level", 0)
    set_attribute(model, "sb", "yes")   # suppress the Ipopt banner
    @variables(model, begin
        0 <= c_m
        0 <= c_f
        0 <= l_m <= 1
        0 <= l_f <= 1
    end)

    @objective(
        model,
        Max,
        (c_m^(1 - γ_c) / (1 - γ_c)) + α_l * (l_m^(1 - γ_l) / (1 - γ_l)) +
        (c_f^(1 - γ_c) / (1 - γ_c)) + α_l * (l_f^(1 - γ_l) / (1 - γ_l))
    )

    @constraint(model, c_m + c_f == w_m * (1 - l_m) + w_f * (1 - l_f))

    optimize!(model)

    return (
        c_m=value(c_m),
        c_f=value(c_f),
        l_m=value(l_m),
        l_f=value(l_f),
        U=objective_value(model)
    )
end
図 1.5 と同じ結果が得られました.
Code
wf_grid = 0.1:0.01:0.9
lm = [solve_jump(w_f=w).l_m for w in wf_grid]
lf = [solve_jump(w_f=w).l_f for w in wf_grid]
p = plot(xlabel=L"w_f", legend=false, xlims=(0.1, 1.0))
plot!(p, wf_grid, lm, lw=2, color=mypalette[6])
plot!(p, wf_grid, lf, lw=2, color=mypalette[2])
annotate!(p, 0.915, lm[end] - 0.02, text(L"l_m", 9, :black, :left))
annotate!(p, 0.915, lf[end] + 0.02, text(L"l_f", 9, :black, :left))
pとても便利に思えますが, いくつか注意点があります.
- 計算の正しさが保証されない. アルゴリズムの中身がブラックボックスであり, 研究者自身が解の正しさを保証できない. 端点解を見逃す可能性や収束しない可能性がある.
- 計算が遅い. 一階条件を直接解く場合と比べると, 問題の複雑さが増すため, 計算が遅くなる. より大規模なモデルを解きたい場合には, 致命的な問題となる可能性がある.
検算目的で使うぐらいに留めておくのが良いでしょう.