using Plots
using ProjectRoot
using LaTeXStrings
using Roots
using LinearAlgebra
using Interpolations
using Distributions
using QuantEcon3 動的計画法
Dynamic Programming
3.1 ベルマン方程式の数値解法
以下の無限期間代表的個人のモデルを考えます. \[ \max_{\{c_t, k_{t+1}\}_{t=0}^{\infty}} \sum_{t=0}^{\infty} \beta^t u(c_t) \quad \text{s.t.} \quad c_t + k_{t+1} = f(k_t) + (1-\delta)k_t. \] これをベルマン方程式 \(V(k)\) に書き換えた時の数値解法を考えます. \[ V(k) = \max_{k'} \left\{u(f(k) + (1-\delta)k - k') + \beta V(k')\right\} \]
大きく分けて, 2つの方法があります.
- Value Function Iteration
- ベルマン方程式の不動点を直接求める方法
- 収束性が保証されているが (証明はA.3節), 収束速度は比較的遅い
- Policy Function Iteration
- 政策関数の不動点を求める方法
- 収束性は保証されていないが, 収束速度は比較的速い
数値計算に用いるために, 以下の関数形とパラメータを仮定します.
- \(u(c) = \log c\)
- \(f(k) = k^\alpha\)
- \(\beta = 0.96\)
- \(\delta = 0.1\)
- \(\alpha = 0.36\)
@kwdef struct Model{TF<:AbstractFloat,TI<:Integer}
    # Parameters
    α::TF = 0.4
    β::TF = 0.96
    δ::TF = 0.1

    # Value Function
    n_k::TI = 101
    k_min::TF = 1.0
    k_max::TF = 10.0
    k_grid::Vector{TF} = collect(range(k_min, k_max, length=n_k))
    Vs::Vector{TF} = zeros(n_k)
    hs::Vector{TF} = copy(k_grid)
end

u(c; m) = log(c)
u_c(c; m) = 1 / c
f(k; m) = k^m.α
f_k(k; m) = m.α * k^(m.α - 1)
3.1.1 Value Function Iteration
アルゴリズム 3.1 (Value Function Iteration)
- \(k\) の定義域 \([k_{\min}, k_{\max}]\) を \(n\) 個のグリッドポイントに分割する.
- \(V(k)\) の初期値 \(\boldsymbol{V}^0\) を適当に設定する. つまり, \(\boldsymbol{V}^0 = (V_0^0, V_1^0, \dots, V_n^0)\) に適当な値を設定する.
- \(\boldsymbol{V}^0\) をベルマン方程式の右辺に代入し, 各 \(k_i\) に対して \(V_i^1\) を計算する.
- 2-3を繰り返す. 収束条件は以下のように設定する.
- \(|\boldsymbol{V}^N - \boldsymbol{V}^{N-1}| < \varepsilon\)
- \(|\boldsymbol{V}^N - \boldsymbol{V}^{N-1}|\) はベクトルのノルム
- \(\varepsilon\) は十分小さな値を設定する. 例えば, \(\varepsilon = 10^{-6}\) とする
VFI がどんな初期値 \(\boldsymbol{V}^0\) から始めても収束するのは, ベルマン方程式の右辺が縮小写像になっているためです (命題 A.3). また, 更新幅を最大値ノルム \(\left\| \boldsymbol{V}^N - \boldsymbol{V}^{N-1} \right\|_{\infty}\) で測り, これが \(\varepsilon\) を下回ったところで止めれば, 真の価値関数との誤差は \(\beta \varepsilon / \left(1 - \beta\right)\) 以下に収まります (命題 A.4). 下の実装 vfi! もこの最大値ノルムで収束を判定しています.
function vfi!(m::Model; tol=1e-6, max_iter=1000, verbose=true)
    (; k_grid, β, δ) = m

    iter, dist = 0, Inf
    Vs_new = similar(m.Vs)
    while dist > tol && iter < max_iter
        for (i_k, k) in enumerate(k_grid)
            c_min = 1e-9 # consumption cannot be negative
            Vs_new[i_k] = maximum(
                log(max(f(k; m) + (1 - δ) * k - k′, c_min)) + β * m.Vs[i_k′]
                for (i_k′, k′) in enumerate(k_grid)
            )
        end

        dist = maximum(abs, Vs_new - m.Vs)
        m.Vs .= Vs_new
        iter += 1
    end

    if verbose
        if iter == max_iter
            println("Warning: Maximum iterations reached.")
        else
            println("Converged in $iter iterations.")
        end
    end

    return nothing
end
Code
m = Model()
vfi!(m)
plot(m.k_grid, m.Vs, label=false, xlabel=L"Capital $k$", ylabel=L"Value $V(k)$")
Converged in 306 iterations.なお, 各イタレーションでは, \(k\) に対する最適な \(k'\) や \(c\) を求めています. それらを記録しておくことで, 政策関数 \(c = h(k)\) や \(k' = g(k)\) を求めることができます.
収束の可視化
スライダー (Iteration \(N\)) を動かすと, 各反復での価値関数 \(V^N(k)\) (実線) が不動点 (灰色の破線) へ収束していく様子を確認できます.
3.1.2 Policy Function Iteration
上記のベルマン方程式から, 以下のオイラー方程式が導出されます. \[ u_c(c) = \beta u_c(c')\left(f_k(k') + (1-\delta)\right). \tag{3.1}\] \(u_c(c) := du(c)/dc\) は限界効用, \(f_k(k) := df(k)/dk\) は資本の限界生産物を表します. ここで消費 \(c\) を選ぶと, 来期の資本は予算制約 \(k' = f(k) + (1-\delta)k - c\) で決まり, 来期の消費は政策関数 \(h(k)\) を所与とすると, \(c' = h(k')\) で与えられます.
ここで, 問題を政策関数 \(h\) の不動点を求める問題に設定します. 反復 \(N\) での推定政策 \(\boldsymbol{h}^N = (h_1^N, \dots, h_n^N)\) はグリッド点 \(\{k_i\}\) 上でしか値を持たないので, これを補間して連続な関数 \(\tilde{h}^N(k)\) に拡張します. 補間は線形でもスプラインでもよく, グリッド点では \(\tilde{h}^N(k_i) = h_i^N\) を満たします. この \(\tilde{h}^N\) を来期の政策としてオイラー方程式の右辺に代入すると, 各グリッド点 \(k_i\) に対して, 今期の消費 \(c\) を未知数とする次の方程式が得られます. \[ \begin{aligned} u_c(c) &= \beta\, u_c\left(\tilde{h}^N(k')\right)\left(f_k(k') + 1 - \delta\right), \\ k' &= f(k_i) + (1-\delta)k_i - c. \end{aligned} \tag{3.2}\] 右辺の \(\tilde{h}^N\) は前の反復から既知なので, これは \(c\) に関する1本の非線形方程式です. これを解いた解が更新後の政策 \(h_i^{N+1}\) であり, 政策が変化しなくなるまで反復すれば政策関数の不動点が得られます.
アルゴリズム 3.2 (Policy Function Iteration)
- \(k\) の定義域 \([k_{\min}, k_{\max}]\) を \(n\) 個のグリッドポイントに分割する.
- 政策関数の初期値 \(\boldsymbol{h}^0 = (h_1^0, \dots, h_n^0)\) を適当に設定する.
- 現在の政策 \(\boldsymbol{h}^N\) を補間して, 連続な関数 \(\tilde{h}^N\) を作る. 各グリッド点 \(k_i\) について 式 3.2 を今期の消費 \(c\) について解き, その解を \(h_i^{N+1}\) とする.
- 3を繰り返す. 収束条件は以下のように設定する.
- \(|\boldsymbol{h}^{N+1} - \boldsymbol{h}^N| < \varepsilon\)
- \(|\boldsymbol{h}^{N+1} - \boldsymbol{h}^N|\) はベクトルのノルム
- \(\varepsilon\) は十分小さな値を設定する. 例えば, \(\varepsilon = 10^{-6}\) とする
実装では, 補間 \(\tilde{h}^N\) を h_itp として表します. これは1回の反復の中では変化しないので, 反復の冒頭で一度だけ構築し, その反復内のすべての find_zero の評価で使い回します (euler_eq には政策のベクトルではなく, この構築済みの h_itp を渡します). ここでは補間に linear_interpolation を使っていますが, スプライン補間などに差し替えても構いません.
function euler_eq(c, k, h_itp; m)
    (; β, δ, k_grid) = m

    k′ = max(f(k; m) + (1 - δ) * k - c, k_grid[begin])
    c′ = h_itp(k′)

    return u_c(c; m) - β * u_c(c′; m) * (f_k(k′; m) + 1 - δ)
end

function pfi!(m::Model; tol=1e-6, max_iter=1000, verbose=true)
    (; k_grid, δ) = m

    hs_new = similar(m.hs)
    iter, dist = 0, Inf
    while dist > tol && iter < max_iter

        # interpolant, once per sweep
        h_itp = linear_interpolation(k_grid, m.hs)
        for (i_k, k) in enumerate(k_grid)
            c_min = max(1e-9, f(k; m) + (1 - δ) * k - k_grid[end])
            c_max = f(k; m) + (1 - δ) * k - k_grid[begin]
            residual_at_c_min = euler_eq(c_min, k, h_itp; m)
            residual_at_c_max = euler_eq(c_max, k, h_itp; m)
            if residual_at_c_min > 0 && residual_at_c_max > 0
                hs_new[i_k] = c_max
            elseif residual_at_c_min < 0 && residual_at_c_max < 0
                hs_new[i_k] = c_min
            else
                hs_new[i_k] = find_zero(c -> euler_eq(c, k, h_itp; m),
                    (c_min, c_max))
            end
        end

        dist = maximum(abs, hs_new .- m.hs)
        m.hs .= hs_new
        iter += 1
    end

    if verbose
        if iter == max_iter
            println("Warning: Maximum iterations reached.")
        else
            println("Converged in $iter iterations.")
        end
    end

    return nothing
end
Code
m = Model()
pfi!(m)
plot(m.k_grid, m.hs, label=false, xlabel=L"Capital $k$",
    ylabel=L"Policy $c = h(k)$")
Converged in 76 iterations.収束の可視化
スライダー (Iteration \(N\)) を動かすと, 各反復での政策関数 \(h^N(k)\) (実線) が不動点 (灰色の破線) へ収束していく様子を確認できます.
価値関数の復元
ここから \(k' := g(k) = f(k) + (1-\delta)k - h(k)\) が求められます. さらに, \(h(k), g(k)\) から価値関数 \(V(k)\) を求める方法は主に2つあります.
- \(V(k) \leftarrow u(h(k)) + \beta V(g(k))\) を用いて \(V(k)\) の不動点を求める方法 (VFI)
- 線形方程式
アルゴリズム 3.3 (価値関数の復元 (線型方程式))
- 離散化された \(k\) から \(k'\) への遷移行列 \(P\) を求める. グリッド \(k_i\) が \(k_j\) と \(k_{j+1}\) の間に遷移する場合, 以下のように定義する.
- \(P_{i, j} = \frac{k_{j+1} - g(k_i)}{k_{j+1} - k_j}\)
- \(P_{i, j+1} = \frac{g(k_i) - k_j}{k_{j+1} - k_j}\)
- \(P_{i, l} = 0, \quad l \neq j, j+1\)
- \(\boldsymbol{u}, \boldsymbol{V}\) を \(u(h(k)), V(k)\) からなる離散化されたベクトルとすると \[ \boldsymbol{V} = \boldsymbol{u} + \beta P \boldsymbol{V}. \]
- \(\boldsymbol{V} = (I - \beta P)^{-1} \boldsymbol{u}\) により \(\boldsymbol{V}\) を求める.
\(P\) の重みは線形補間の重みそのものです. \(P \boldsymbol{V}\) の \(i\) 行目は \(P_{i, j} V_j + P_{i, j+1} V_{j+1}\) であり, 来期の価値 \(V(g(k_i))\) を両隣のグリッド点の値から線形補間したもの (2.1節) になっています. 幾何的には, \(g(k_i)\) が区間 \([k_j, k_{j+1}]\) を内分する比で重みが決まり, 各点の重みは反対側の区間の長さに比例します (図 3.3). \(g(k_i)\) に近いグリッド点ほど大きな重みを受け取ります.
注: 点線は真の価値関数 (イメージ), 黒線は \(V_j\) と \(V_{j+1}\) の線形補間. 下の各区間の長さを \(k_{j+1} - k_j\) で割ったものが, 同じ色のグリッド点の重み \(P_{i, j}, P_{i, j+1}\) になる.
ここでは, より高速な線型方程式を用いる方法を実装します. より速度を求める場合, 遷移行列はほとんどの要素がゼロであるため, 疎行列 (Sparse Matrix) を用いることで高速化する可能性があります. Juliaの場合, SparseArrays.jl で実装されています.
重みの計算は関数 lottery にまとめます. これは \(g(k_i)\) を挟む2つのグリッド点の番号と, 下側の点の重み \(\omega = P_{i, j}\) を返します.
function lottery(x, x_grid)
    n = length(x_grid)
    x <= x_grid[begin] && return (1, 1, 1.0)
    x >= x_grid[end] && return (n, n, 1.0)
    j = searchsortedlast(x_grid, x)
    ω = (x_grid[j+1] - x) / (x_grid[j+1] - x_grid[j])
    return (j, j + 1, ω)
end
function compute_vf!(m::Model)
(; hs, n_k, k_grid, β, δ) = m
P = zeros(n_k, n_k)
for (i_k, k) in enumerate(k_grid)
g = f(k; m) + (1 - δ) * k - hs[i_k]
j_lo, j_hi, ω = lottery(g, k_grid)
P[i_k, j_lo] += ω
P[i_k, j_hi] += 1 - ω
end
m.Vs .= (I - β * P) \ (u.(hs; m))
return nothing
endCode
compute_vf!(m)
plot(m.k_grid, m.Vs, label=false, xlabel=L"Capital $k$", ylabel=L"Value $V(k)$")実行速度の比較
VFIよりもPFIの方が収束速度が速いことは確認しましたが, 実行速度も速いことも確認できます.
using BenchmarkTools
println("Value function iteration:")
@benchmark vfi!(m, verbose=false) setup = (m = Model())
Value function iteration:BenchmarkTools.Trial: 69 samples with 1 evaluation per sample. Range (min … max): 71.912 ms … 75.912 ms ┊ GC (min … max): 0.00% … 0.00% Time (median): 72.256 ms ┊ GC (median): 0.00% Time (mean ± σ): 72.489 ms ± 664.991 μs ┊ GC (mean ± σ): 0.00% ± 0.00% █▁▃ ▃▁▁▁███▇▄▅▃▃▄▄▄▄▁▁▁▁▁▃▁▃▁▁▁▁▁▁▁▁▁▃▁▁▁▃▁▁▁▁▁▁▁▁▁▃▁▁▁▁▁▁▁▁▁▁▁▃ ▁ 71.9 ms Histogram: frequency by time 75.1 ms < Memory estimate: 278.22 KiB, allocs estimate: 614.
println("Policy function iteration:")
@benchmark (pfi!(m, verbose=false); compute_vf!(m)) setup = (m = Model())
Policy function iteration:BenchmarkTools.Trial: 137 samples with 1 evaluation per sample. Range (min … max): 36.220 ms … 39.058 ms ┊ GC (min … max): 0.00% … 0.00% Time (median): 36.411 ms ┊ GC (median): 0.00% Time (mean ± σ): 36.717 ms ± 563.328 μs ┊ GC (mean ± σ): 0.04% ± 0.22% ▁█▄ ▃███▇▁▁▄▃▃▁▄▄▅▅▄▄▃▅▃▄▃▃▁▃▃▃▃▁▃▃▁▁▁▁▁▁▁▁▁▃▁▃▁▃▃▃▁▁▃▁▁▁▃▁▁▁▃▁▃ ▃ 36.2 ms Histogram: frequency by time 38.7 ms < Memory estimate: 461.69 KiB, allocs estimate: 324.
3.1.3 Endogenous Grid Method
PFI では各グリッド点でオイラー方程式という非線形の方程式の求根していました. Endogenous Grid Method (EGM) (Carroll 2006) は, この求根を避ける高速な政策関数反復です. アイデアは, 今期の資本 \(k\) をグリッドに固定するのではなく, 来期の資本 \(k'\) をグリッドに固定し, オイラー方程式と予算制約を後ろ向きに解くことです.
来期消費の政策 \(c' = h(k')\) を所与とすると, オイラー方程式 (3.1) から今期の消費 \(c\) は閉形式で求められます. \[ c = u_c^{-1}\left(\beta\, u_c\left(h(k')\right)\left(f_k(k') + 1 - \delta\right)\right). \] 次に予算制約から今期の資本 \(k\) を求めます. 資源関数 \(m(k) := f(k) + (1 -\delta) k\) とすると, 予算制約は \(c + k' = m(k)\) となるので, これを \(k\) について解くと \[ k = m^{-1}(c + k'). \] なお, \(m(k)\) は明らかに単調なので, 逆関数 \(m^{-1}\) は一意に定まります. また, \(m^{-1}\) は反復の前に決定されているので, 一度だけ計算しておけば良いです. これを用いることで, \((c, k)\) の組を求めることができ, グリッド上の点に保管することで, 新しい政策関数 \(g(\cdot)\) を構築できます.
アルゴリズム 3.4 (Endogenous Grid Method)
- 来期資本 \(k'\) のグリッドを固定し, 資源関数の逆関数 \(m^{-1}(\cdot)\) を一度だけ構築する.
- 政策関数の初期値 \(\boldsymbol{h}^0 = (h_1^0, \dots, h_n^0)\) を適当に設定する.
- 政策 \(\tilde{h}^N(k')\) を所与に, 各グリッド点 \(k'_j\) について
- オイラー方程式から今期消費 \(c_j = u_c^{-1}\left(\beta u_c(h(k'_j))(f_k(k'_j) + 1 - \delta)\right)\) を求める.
- 予算制約から今期資本 \(k_j = m^{-1}(c_j + k'_j)\) を求める.
- 内生グリッド \((k_j, c_j)\) を補間して, 固定グリッド上の新しい政策 \(h^{N+1}(k)\) を得る.
- 政策が収束するまで 3-4 を繰り返す.
u_c_inv(marg_u; m) = 1 / marg_u

function egm!(m::Model; tol=1e-6, max_iter=1000, verbose=true)
    (; k_grid, β, δ) = m

    # Construct the resource function and its inverse
    resources = f.(k_grid; m) .+ (1 - δ) .* k_grid
    m⁻¹ = linear_interpolation(resources, k_grid, extrapolation_bc=Line())

    hs_new = similar(m.hs)
    cs_endog = similar(k_grid)
    ks_endog = similar(k_grid)
    iter, dist = 0, Inf
    while dist > tol && iter < max_iter
        for (j, k′) in enumerate(k_grid)                    # fix k' on the grid
            rhs = β * u_c(m.hs[j]; m) * (f_k(k′; m) + 1 - δ)  # m.hs[j] is c(k'_j)
            cs_endog[j] = u_c_inv(rhs; m)
            ks_endog[j] = m⁻¹(cs_endog[j] + k′)             # m(k) = c + k'
        end
        # interpolate the endogenous grid back onto the fixed grid
        c_itp = linear_interpolation(ks_endog, cs_endog,
            extrapolation_bc=Line())
        for (i, k) in enumerate(k_grid)
            hs_new[i] = c_itp(k)
        end
        dist = maximum(abs, hs_new - m.hs)
        m.hs .= hs_new
        iter += 1
    end

    if verbose
        if iter == max_iter
            println("Warning: Maximum iterations reached.")
        else
            println("Converged in $iter iterations.")
        end
    end

    return nothing
end
Code
m = Model()
egm!(m)
plot(m.k_grid, m.hs, label=false, xlabel=L"Capital $k$",
    ylabel=L"Policy $c = h(k)$")
Converged in 76 iterations.VFI, PFI と同じ政策関数が得られます. EGM は反復の中で求根を行わないため, さらに高速です.
println("Endogenous grid method:")
@benchmark (egm!(m, verbose=false); compute_vf!(m)) setup = (m = Model())
Endogenous grid method:BenchmarkTools.Trial: 9149 samples with 1 evaluation per sample. Range (min … max): 497.416 μs … 1.515 ms ┊ GC (min … max): 0.00% … 0.00% Time (median): 535.917 μs ┊ GC (median): 0.00% Time (mean ± σ): 546.290 μs ± 45.472 μs ┊ GC (mean ± σ): 1.32% ± 5.23% █▇▄▃▃▃▁ ▁ ▇▅▁▃▄▄▁████████▇█▇▆▅▆▄▄▅▃▁▁▃▁▁▃▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▁▄▆█▇▇██ █ 497 μs Histogram: log(frequency) by time 793 μs < Memory estimate: 465.31 KiB, allocs estimate: 332.
3.2 確率的なモデル
前節では決定論的な動学モデルを扱いました. ここでは確率的な不確実性を導入します. 生産関数 \(f(k, z) = z k^\alpha\) とし, 生産性 \(z\) が確率的に変化するモデルを考えます. 生産性 \(z\) は以下のような AR(1) 過程に従うとします. \[
\log z' = (1 - \rho) \mu + \rho \log z + \sigma \varepsilon, \quad \varepsilon \sim \mathcal{N}(0, 1).
\] この時, ベルマン方程式は以下のように書き換えられます. \[
V(k, z) = \max_{k'} \left\{u(f(k, z) + (1-\delta)k - k') + \beta \mathbb{E}[V(k', z') \mid z]\right\}.
\] この \(V(k, z)\) を数値計算するためには, \(z\) の状態空間を離散化する必要があります. 離散化には2.4節で学んだ Rouwenhorst 法を使います. これは持続性の高い AR(1) 過程でも定常分散と自己相関を厳密に一致させられるため, Tauchen 法より望ましい選択です. QuantEcon.jl の rouwenhorst が返す遷移行列を \(\Pi\) と書きます.
z_chain = rouwenhorst(5, 0.9, 1.0, 0.1) # rouwenhorst(N, ρ, σ, μ)
println("Grid: ", round.(collect(z_chain.state_values), digits=3))
println("Transition matrix Π:")
z_chain.p
Grid: [-3.588, -1.294, 1.0, 3.294, 5.588]
Transition matrix Π:5×5 Matrix{Float64}:
0.814506 0.171475 0.0135375 0.000475 6.25e-6
0.0428688 0.821275 0.128963 0.006775 0.00011875
0.00225625 0.085975 0.823537 0.085975 0.00225625
0.00011875 0.006775 0.128963 0.821275 0.0428688
6.25e-6 0.000475 0.0135375 0.171475 0.8145063.2.1 Value Function Iteration
AR(1) process を \(\Pi\) で離散化した後のベルマン方程式は以下のようになります. \[ V(k, z) = \max_{k'} \left\{u(f(k, z) + (1-\delta)k - k') + \beta \sum_{z'} \pi(z' \mid z) V(k', z')\right\}. \] VFIを用いる場合, 実装は価値関数 \(V\) の次元を \(z\) のために1つ増やし, ベルマン方程式の通り実装するだけです. 資本のグリッドは決定論的なモデルと揃えて \([1, 10]\) とします.1
@kwdef struct StochasticModel{TF<:AbstractFloat,TI<:Integer}
    # Parameters
    α::TF = 0.4
    β::TF = 0.96
    δ::TF = 0.1
    # AR(1) process
    ρ::TF = 0.9
    μ::TF = 0.0
    σ::TF = 0.04

    # Value Function
    n_k::TI = 101
    n_z::TI = 5
    k_min::TF = 1.0
    k_max::TF = 10.0
    k_grid::Vector{TF} = collect(range(k_min, k_max, length=n_k))
    z_chain::MarkovChain = rouwenhorst(n_z, ρ, σ, μ)
    z_grid::Vector{TF} = collect(exp.(z_chain.state_values))
    Π::Matrix{TF} = z_chain.p
    V::Matrix{TF} = zeros(n_k, n_z)
    h::Matrix{TF} = repeat(k_grid, 1, n_z)
end

f(k, z; m) = z * k^m.α
f_k(k, z; m) = z * m.α * k^(m.α - 1)
function vfi!(m::StochasticModel; tol=1e-6, max_iter=1000, verbose=true)
(; k_grid, z_grid, β, δ, Π) = m
iter, dist = 0, Inf
V_new = similar(m.V)
while dist > tol && iter < max_iter
for (i_z, z) in enumerate(z_grid), (i_k, k) in enumerate(k_grid)
c_min = 1e-9 # consumption cannot be negative
V_new[i_k, i_z] = maximum(
log(max(f(k, z; m) + (1 - δ) * k - k′, c_min)) +
β * sum(Π[i_z, i_z′] * m.V[i_k′, i_z′]
for (i_z′, z′) in enumerate(z_grid))
for (i_k′, k′) in enumerate(k_grid)
)
end
dist = maximum(abs, V_new .- m.V)
m.V .= V_new
iter += 1
end
if verbose
if iter == max_iter
println("Warning: Maximum iterations reached.")
else
println("Converged in $iter iterations.")
end
end
return nothing
endCode
m_stoch = StochasticModel()
vfi!(m_stoch)
p = plot(m_stoch.k_grid, m_stoch.V[:, 5], label=L"z_5",
    xlabel=L"Capital $k$", ylabel=L"Value $V(k, z)$")
for i in 4:-1:1
    plot!(m_stoch.k_grid, m_stoch.V[:, i], label=L"z_%$i")
end

p
Converged in 306 iterations.3.2.2 Policy Function Iteration
PFI も同じように拡張できます. 不確実性の下でのオイラー方程式は, 来期の生産性 \(z'\) についての期待値を取る形になります. \[ \begin{aligned} u_c(c) &= \beta\, \mathbb{E}\left[u_c(c')\left(f_k(k', z') + 1 - \delta\right) \mid z\right] \\ &= \beta \sum_{z'} \pi(z' \mid z)\, u_c\left(\tilde{h}(k', z')\right)\left(f_k(k', z') + 1 - \delta\right). \end{aligned} \tag{3.3}\] 決定論的な場合 (式 3.2) との違いは2点だけです. 第一に, 政策関数が \(h(k, z)\) と2変数になるため, 補間は生産性の状態ごとに1本ずつ, 計 \(n_z\) 本の \(\tilde{h}(\cdot, z')\) を作ります. \(z\) はグリッド上の有限個の状態しか取らないので, 補間が必要なのは \(k\) の方向だけです. 第二に, 右辺が \(\pi(z' \mid z)\) による期待値になります. なお予算制約 \(k' = f(k, z) + (1-\delta)k - c\) に入るのは今期の \(z\) である点に注意してください.
function euler_eq(c, k, i_z, h_itps; m)
    (; β, δ, k_grid, z_grid, Π) = m

    k′ = clamp(f(k, z_grid[i_z]; m) + (1 - δ) * k - c,
        k_grid[begin], k_grid[end])
    rhs = sum(Π[i_z, i_z′] * u_c(h_itps[i_z′](k′); m) * (f_k(k′, z′; m) + 1 - δ)
              for (i_z′, z′) in enumerate(z_grid))

    return u_c(c; m) - β * rhs
end

function pfi!(m::StochasticModel; tol=1e-6, max_iter=1000, verbose=true)
    (; k_grid, z_grid, δ, n_z) = m

    h_new = similar(m.h)
    iter, dist = 0, Inf
    while dist > tol && iter < max_iter

        # build one interpolant per productivity state, once per sweep
        h_itps = [linear_interpolation(k_grid, m.h[:, i_z′]) for i_z′ in 1:n_z]
        for (i_z, z) in enumerate(z_grid), (i_k, k) in enumerate(k_grid)
            cash_on_hand = f(k, z; m) + (1 - δ) * k
            c_min = max(1e-9, cash_on_hand - k_grid[end])
            c_max = cash_on_hand - k_grid[begin]
            residual_at_c_min = euler_eq(c_min, k, i_z, h_itps; m)
            residual_at_c_max = euler_eq(c_max, k, i_z, h_itps; m)
            if residual_at_c_min > 0 && residual_at_c_max > 0
                h_new[i_k, i_z] = c_max
            elseif residual_at_c_min < 0 && residual_at_c_max < 0
                h_new[i_k, i_z] = c_min
            else
                h_new[i_k, i_z] = find_zero(c -> euler_eq(c, k, i_z, h_itps; m),
                    (c_min, c_max))
            end
        end

        dist = maximum(abs, h_new .- m.h)
        m.h .= h_new
        iter += 1
    end

    if verbose
        if iter == max_iter
            println("Warning: Maximum iterations reached.")
        else
            println("Converged in $iter iterations.")
        end
    end

    return nothing
end
Code
m_stoch_pfi = StochasticModel()
pfi!(m_stoch_pfi)
p = plot(m_stoch_pfi.k_grid, m_stoch_pfi.h[:, 5], label=L"z_5",
    xlabel=L"Capital $k$", ylabel=L"Policy $h(k, z)$")
for i in 4:-1:1
    plot!(m_stoch_pfi.k_grid, m_stoch_pfi.h[:, i], label=L"z_%$i")
end

p
Converged in 77 iterations.価値関数の復元
価値関数の復元は決定論的な場合 (アルゴリズム 3.3) と同じです. 違いは状態が \((k, z)\) になる点だけで, \((k, z)\) から \((k_j, z')\) への遷移確率は lottery の重みと \(\pi(z' \mid z)\) の積になります.
function compute_vf!(m::StochasticModel)
    (; h, n_k, n_z, k_grid, z_grid, β, δ, Π) = m
    n_kz = n_k * n_z
    state_index(i_k, i_z) = i_k + (i_z - 1) * n_k  # linear index for (k, z)
    P = zeros(n_kz, n_kz)
    us = zeros(n_kz)
    for (i_z, z) in enumerate(z_grid), (i_k, k) in enumerate(k_grid)
        row = state_index(i_k, i_z)
        us[row] = u(h[i_k, i_z]; m)
        g = f(k, z; m) + (1 - δ) * k - h[i_k, i_z]   # next capital k'(k, z)
        j_lo, j_hi, ω = lottery(g, k_grid)
        for i_z′ in 1:n_z
            P[row, state_index(j_lo, i_z′)] += ω * Π[i_z, i_z′]
            P[row, state_index(j_hi, i_z′)] += (1 - ω) * Π[i_z, i_z′]
        end
    end
    m.V .= reshape((I - β * P) \ us, n_k, n_z)
    return nothing
end
Code
compute_vf!(m_stoch_pfi)
p = plot(m_stoch_pfi.k_grid, m_stoch_pfi.V[:, 5], label=L"z_5",
    xlabel=L"Capital $k$", ylabel=L"Value $V(k, z)$")
for i in 4:-1:1
    plot!(m_stoch_pfi.k_grid, m_stoch_pfi.V[:, i], label=L"z_%$i")
end

p3.2.3 Endogenous Grid Method
EGM も確率的なモデルに自然に拡張できます. 来期の資本 \(k'\) をグリッド上に固定し, 各生産性 \(z\) についてオイラー方程式 (式 3.3) の右辺を評価すると, 今期の消費 \(c\) が求根なしに求まります. \[ c = u_c^{-1}\left( \beta \sum_{z'} \pi(z' \mid z)\, u_c\left(\tilde{h}(k', z')\right)\left(f_k(k', z') + 1 - \delta\right) \right). \] この \(c\) から資源制約 \(c + k' = z k^\alpha + (1-\delta)k\) を \(k\) について解けば内生グリッドが得られます. 決定論的な場合との違いは2点だけです. 第一に, 右辺が \(\pi(z' \mid z)\) による期待値になります. 第二に, 資源制約の左辺 \(M(k, z) = z k^\alpha + (1-\delta)k\) が今期の \(z\) に依存するので, その逆関数 \(M^{-1}(\cdot, z)\) を生産性の状態ごとに1本ずつ用意します.
function egm!(m::StochasticModel; tol=1e-6, max_iter=1000, verbose=true)
    (; k_grid, z_grid, β, δ, Π, n_z) = m
    # resource function M(k, z) = z k^α + (1-δ)k, inverse per state
    M⁻¹ = [linear_interpolation(z .* k_grid .^ m.α .+ (1 - δ) .* k_grid, k_grid,
        extrapolation_bc=Line()) for z in z_grid]
    c = copy(m.h)  # h holds the consumption policy
    c_new = similar(c)
    cs_endog = similar(k_grid)
    ks_endog = similar(k_grid)
    iter, dist = 0, Inf
    while dist > tol && iter < max_iter
        for (i_z, z) in enumerate(z_grid)
            for (j, k′) in enumerate(k_grid)               # fix k' on the grid
                rhs = β * sum(Π[i_z, i_z′] * u_c(c[j, i_z′]; m) *
                    (f_k(k′, z′; m) + 1 - δ)
                              for (i_z′, z′) in enumerate(z_grid))
                cs_endog[j] = 1 / rhs  # u_c⁻¹(rhs) since u = log
                ks_endog[j] = M⁻¹[i_z](cs_endog[j] + k′)  # invert M(k, z)
            end
            c_itp = linear_interpolation(ks_endog, cs_endog,
                extrapolation_bc=Line())
            for (i, k) in enumerate(k_grid)
                c_new[i, i_z] = c_itp(k)
            end
        end
        dist = maximum(abs, c_new - c)
        c .= c_new
        iter += 1
    end
    m.h .= c

    if verbose
        if iter == max_iter
            println("Warning: Maximum iterations reached.")
        else
            println("Converged in $iter iterations.")
        end
    end

    return nothing
end
Code
m_stoch_egm = StochasticModel()
egm!(m_stoch_egm)
p = plot(m_stoch_egm.k_grid, m_stoch_egm.h[:, 5], label=L"z_5",
    xlabel=L"Capital $k$", ylabel=L"Policy $h(k, z)$")
for i in 4:-1:1
    plot!(m_stoch_egm.k_grid, m_stoch_egm.h[:, i], label=L"z_%$i")
end

p
Converged in 77 iterations.決定論的な場合と同様に, EGM は求根も期待値の内側での最適化も要らず, PFI と同じ政策関数により少ない計算コストで到達します.
3.3 Aiyagari モデル
数値計算を行う最大のモチベーションは, 異質な個人を扱うということです. コアマクロで扱った, Ramsey 型の代表的個人モデルを自然に拡張したものが Aiyagari モデルです (Aiyagari 1994). 家計の問題は3.2節の確率的なモデルとほぼ同じで, 違いは (1) ショックが家計ごとに独立な個別ショックであること, (2) 借入制約があることの2点です.
3.3.1 モデル
質量 \(1\) の連続体の家計が存在します. 各家計は無限期間生存し, 割引因子 \(\beta \in (0, 1)\) で期待効用を最大化します. \[ \mathbb{E}_0 \sum_{t=0}^{\infty} \beta^t\, u(c_t), \qquad u(c) = \frac{c^{1-\gamma}}{1-\gamma}. \] ここで \(\gamma > 0\) は相対的リスク回避度です. 各家計は労働生産性 \(z_t\) という個別ショック (idiosyncratic shock) に直面します. これは家計ごとに独立であり, 大数の法則によって経済全体では平均化されるため, マクロの集計的な不確実性 (Aggregate shock) はありません. \(z_t\) は AR(1) 過程に従います. \[ \log z_{t+1} = \rho \log z_t + \sigma \varepsilon_{t+1}, \qquad \varepsilon_{t+1} \sim \mathcal{N}(0, 1). \] その定常分布を \(\Phi(z)\), 遷移分布を \(\Pi\left(z' \mid z\right)\) と書きます.
家計が保有できる資産は単一の安全資産 \(a_t\) のみです. 実質賃金 \(w\) と実質利子率 \(r\) を所与として, 予算制約は \[ c_t + a_{t+1} = w z_t + (1 + r)\, a_t \] で与えられます. 市場が不完備なのは, 家計が \(z_t\) の変動を保険できる資産がこの 1 種類しかないためです. さらに, 家計は無制限には借入できず, 借入制約 (borrowing constraint) \[ a_{t+1} \geq -\underline{a}, \qquad \underline{a} \geq 0 \] に直面します. \(\underline{a} = 0\) ならば借入は一切できず, 資産は非負に限られます. 以下ではこの場合を考えます.
3.3.2 家計の動的計画問題
状態変数は手持ちの資産 \(a\) と生産性 \(z\) の組 \((a, z)\) です. 予算制約から消費を \(c = wz + (1+r)a - a'\) と書けるので, 価値関数 \(V(a, z)\) は価格 \((r, w)\) を所与として, 次のベルマン方程式を満たします. \[ V(a, z) = \max_{a' \geq -\underline{a}}\left\{ u\left( wz + (1+r)a - a' \right) + \beta\, \mathbb{E}\left[ V(a', z') \mid z \right] \right\}. \tag{3.4}\] この解を貯蓄の政策関数 \(a' = g(a, z)\) と消費の政策関数 \(c(a, z)\) とします.
この問題は, 借入制約を除けば, これまでの代表的個人の問題と同じ構造であり, VFI・PFI・EGM のいずれでも解けます. 以下では, オイラー方程式を求根なしに解ける EGM を用います.
借入制約が内点解となる (\(a' > -\underline{a}\) の) 領域では, 一階条件としてオイラー方程式が成立します. 制約が拘束する可能性まで含めると, 次の相補性条件 (Kuhn-Tucker 条件) になります. \[ u_c\left( c(a, z) \right) \geq \beta (1+r)\, \mathbb{E}\left[ u_c\left( c(a', z') \right) \mid z \right]. \tag{3.5}\] 等式は \(a' > -\underline{a}\) のとき成立します.
3.3.3 企業と価格
生産側は, コブ・ダグラス型生産関数 \(Y = K^{\alpha} L^{1-\alpha}\) を持つ代表的企業で記述されます. \(\delta\) を資本減耗率とすると, 競争市場での利潤最大化条件 (要素価格 = 限界生産性) から, 価格は資本労働比 \(K/L\) の関数として決まります. \[ r = \alpha \left( \frac{K}{L} \right)^{\alpha - 1} - \delta, \qquad w = (1-\alpha) \left( \frac{K}{L} \right)^{\alpha} \tag{3.6}\] 逆に解くと, 利子率 \(r\) から企業の資本需要が定まります. \[ K^d(r) = L \left( \frac{\alpha}{r + \delta} \right)^{\frac{1}{1-\alpha}}, \qquad w(r) = (1-\alpha) \left( \frac{\alpha}{r + \delta} \right)^{\frac{\alpha}{1-\alpha}}. \tag{3.7}\] 労働は非弾力的に供給され, 総労働は生産性の定常分布での平均 \(L = \int z\, d\Phi(z)\) に等しくなります. 以下では生産性を基準化して \(L = 1\) とします.
3.3.4 定常均衡
家計が政策関数 \(g(a, z)\) に従って動くと, 状態 \((a, z)\) の分布が経済全体に生まれます. その分布が時間を通じて不変になったものが定常分布です.
定義 3.1 (定常一般均衡 (Stationary Recursive Competitive Equilibrium)) 価格 \((r, w)\), 価値関数 \(V\), 政策関数 \(g\), そして \((a, z)\) の同時分布関数 \(\Lambda\left(a, z\right) = \Pr\left(a_t \leq a,\, z_t \leq z\right)\) の組が, 次を満たすとき定常均衡という.
- 家計最適化: \((V, g)\) は所与の \((r, w)\) のもとで 式 3.4 を解く.
- 企業最適化: \((r, w)\) は 式 3.6 を満たす.
- 分布の定常性: \(\Lambda\) は政策 \(g\) とショックの遷移 \(\Pi\) のもとで不変である. すなわち, 任意の \(\left(a', z'\right) \in [-\underline{a}, \infty) \times \mathbb{R}_{++}\) に対して, \[ \Lambda\left(a', z'\right) = \int \mathbb{1}\left\{ g(a, z) \leq a' \right\} \Pi\left(z' \mid z\right) d\Lambda(a, z). \] 右辺は, 今期 \(\Lambda\) に従う家計のうち, 貯蓄が \(a'\) 以下で, かつ生産性が \(z'\) 以下に遷移する家計の割合である. 借入制約に張り付く家計の質量は \(a = -\underline{a}\) での \(\Lambda\) のジャンプとして現れる.
- 資産市場の清算: 家計の総資産供給が企業の資本需要に等しい. \[ \underbrace{\int a\, d\Lambda(a, z)}_{\text{capital supply } K^s(r)} = \underbrace{K^d(r)}_{\text{capital demand}}. \tag{3.8}\]
代表的個人モデル (完備市場) では, 定常状態で必ず \(1 + r = 1/\beta\), すなわち \(r = 1/\beta - 1\) が成立しました. Aiyagari モデルの核心は, 不完備市場では均衡利子率がこれより低くなることです. \[ r^* < \frac{1}{\beta} - 1. \]
Note市場が完備な場合
完備市場とは, 個別状態 \(z\) のあらゆる実現に対して支払いが条件づけられた証券 (Arrow 証券) を家計が自由に売買できる状況を指します. 本モデルには集計的な不確実性がない (個別ショックは大数の法則で平均化される) ため, 個別リスクは完全に分散可能です. したがって均衡では完全なリスク分散 (perfect risk sharing) が達成され, 各家計の消費は個別状態 \(z\) に依存しなくなります.
これを家計の問題で確認しましょう. 完備市場では予算制約が生涯の一本の異時点間制約に統合され, 状態ごとの借入制約 \(a' \geq -\underline{a}\) は均衡で拘束しません. このとき 式 3.5 は等号で成立し, さらにリスク分散により \(c_{t+1}\) が確実 (個別状態によらず一定) になるので, 右辺の期待値が外れて \[ u_c(c_t) = \beta (1+r)\, u_c(c_{t+1}) \] となります. 集計的な不確実性も成長もない定常状態では消費は一定 \(c_t = c_{t+1}\) なので \(u_c(c_t) = u_c(c_{t+1})\) となり, \[ 1 = \beta (1 + r) \quad\Longleftrightarrow\quad r = \frac{1}{\beta} - 1. \] すなわち均衡利子率は時間選好率にちょうど一致します. これは, 集計量が代表的個人の新古典派成長モデルと同じ修正黄金律に従うことの帰結でもあります. 完備市場では予備的貯蓄の動機が消えるため, 資本供給曲線 \(K^s(r)\) は 図 3.13 の不完備市場の曲線よりも左に位置し, \(r = 1/\beta - 1\) で初めて発散します. 不完備市場の均衡 \(r^*\) がその手前に来るのは, この予備的貯蓄の分だけ供給が右に膨らむためです.
直観は予備的貯蓄にあります. 家計は保険できない所得リスクに備えて自衛的に貯蓄するため, \(r\) が \(1/\beta - 1\) より低くても正の純資産を持とうとします. その結果, 資本供給 \(K^s(r)\) は右上がりで \(r \to 1/\beta - 1\) で発散する一方, 資本需要 \(K^d(r)\) は 式 3.7 より右下がりです. 両者の交点である均衡 \(r^*\) は, 必ず \(1/\beta - 1\) の手前に来ます.
Note予備的貯蓄 (precautionary saving)
CRRA 効用は \(u_{ccc}(c) > 0\) を満たします. このとき, イェンセンの不等式から将来消費の不確実性は限界効用の期待値 \(\mathbb{E}[u_c(c')]\) を引き上げます. 式 3.5 の右辺が大きくなるため, 家計は現在の消費を抑えて余分に貯蓄する誘因を持ちます. これを予備的貯蓄と呼びます. Arrow 証券がある完備市場では, 上で見たように来期の消費が個別状態 \(z'\) によらず確実になるので, この動機は生じません. 予備的貯蓄は, 市場の不完備性に固有の貯蓄動機です.
図 3.10 は, イェンセンの不等式の部分を図にしたものです. \(u_c\) が凸なので, 2 点 \(\left(c'_L, u_c\left(c'_L\right)\right)\) と \(\left(c'_H, u_c\left(c'_H\right)\right)\) を結ぶ弦は曲線より上にあります. その中点の高さが限界効用の期待値 \(\mathbb{E}[u_c(c')]\) (赤い点) で, 平均と同じ消費を確実に得るときの限界効用 \(u_c(\mathbb{E}[c'])\) (青い点) を上回ります. 平均を変えずにリスクだけを加えると, 式 3.5 の右辺はこの差の \(\beta\left(1 + r\right)\) 倍だけ上がります.
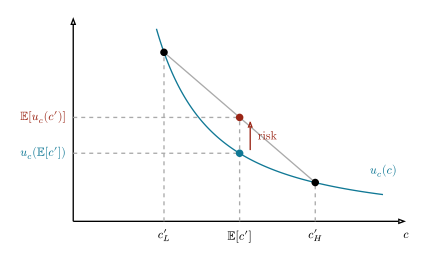
注: 概念図. 来期の消費 \(c'\) は確率 \(1/2\) ずつで \(c'_L\) か \(c'_H\) をとるので, 弦の中点が期待値を表す.
3.3.5 数値解法
均衡の探索は, 利子率 \(r\) に関する一次元の求根問題に帰着します. 与えられた \(r\) に対して家計の問題を解いて資本供給 \(K^s(r)\) を集計し, 式 3.8 の超過需要 \(K^d(r) - K^s(r)\) がゼロになる \(r\) を探します.
アルゴリズム 3.5 (Aiyagari モデルの解法) 外側ループ (一般均衡): 超過需要 \(K^d(r) - K^s(r) = 0\) を \(r\) について解く. \(K^s(r)\) は次の手順で評価する.
- \(r\) を所与として, 式 3.7 から賃金 \(w(r)\) を計算する.
- 内側ループ (家計): EGM でオイラー方程式 (式 3.5) を解き, 貯蓄の政策 \(g(a, z)\) を得る.
- 政策 \(g\) のもとで遷移行列 \(P\) を作り, 線形方程式を解いて定常分布 \(\Lambda\) を求める.
- 総資産 \(K^s(r) = \int a\, d\Lambda\) を集計する.
\(K^s(r)\) は \(r\) について増加, \(K^d(r)\) は減少するので, 超過需要は単調減少である. したがって二分法 (1.1節) が安定に使える.
パラメータの設定
モデルのパラメータと, 状態空間 (資産グリッドと生産性グリッド) を AiyagariModel にまとめます. 借入制約 \(a \geq 0\) の近くで政策関数が大きく曲がるため, 資産グリッドは原点付近を密にとります.2 生産性は3.2節と同じく Rouwenhorst 法で \(n_z\) 状態のマルコフ連鎖に離散化し, その不変分布 (\(\Phi\) に対応) での平均が \(1\) になるよう基準化して, 総労働を \(L = 1\) とします. 不変分布は QuantEcon.jl の stationary_distributions で求めます.
# normalize so that E[z] = 1
normalize_mean(z_grid, z_probs) = z_grid ./ dot(z_probs, z_grid)

@kwdef struct AiyagariModel{TF<:AbstractFloat,TI<:Integer}
    β::TF = 0.96
    γ::TF = 2.0
    α::TF = 0.36
    δ::TF = 0.08
    ρ::TF = 0.9
    σ::TF = 0.2
    L::TF = 1.0
    n_a::TI = 200
    n_z::TI = 7
    a_max::TF = 50.0
    # dense near origin
    a_grid::Vector{TF} = (range(0, 1, length=n_a)) .^ 2 .* a_max
    z_chain::MarkovChain = rouwenhorst(n_z, ρ, σ)  # QuantEcon.jl
    z_grid::Vector{TF} = normalize_mean(exp.(collect(z_chain.state_values)),
        stationary_distributions(z_chain)[1])
    Π::Matrix{TF} = z_chain.p
end

K_demand(r, m) = m.L * (m.α / (r + m.δ))^(1 / (1 - m.α))
wage(r, m) = (1 - m.α) * (m.α / (r + m.δ))^(m.α / (1 - m.α))
家計の問題
オイラー方程式 (式 3.5) を EGM で解きます. 手順は3.2節と同じで, 新しいのは借入制約の扱いだけです. 内生グリッドの下端 (コードの as_endog[1]) は \(a' = 0\) を選ぶ家計に対応するので, 手持ち資産がこれより小さい家計では制約が拘束します. その領域では \(a' = 0\) に張り付き, 消費は予算制約から \(c = wz + (1+r)a\) となります.
u_c(c, γ) = c^(-γ)
u_c_inv(marg_u, γ) = marg_u^(-1 / γ)

# EGM: iterate the consumption policy c(a, z); return saving policy a'
function solve_household(r, m; tol=1e-9, max_iter=10_000)
    (; β, γ, z_grid, Π, a_grid, n_a, n_z) = m
    w = wage(r, m)
    # initial guess: labor income + interest
    c = w .* z_grid' .+ max(r, 1e-4) .* a_grid
    c_new = similar(c)
    as_endog = similar(a_grid)
    cs_endog = similar(a_grid)
    for _ in 1:max_iter
        # expected marginal utility at (a', z): Σ_z' π(z'|z) u_c(c(a', z'))
        expected_u_c = (u_c.(c, γ)) * Π'
        for i_z in 1:n_z
            for i_a′ in 1:n_a
                # invert the Euler eq., then the budget for the endogenous asset
                cs_endog[i_a′] = u_c_inv(β * (1 + r) * expected_u_c[i_a′, i_z], γ)
                as_endog[i_a′] =
                    (cs_endog[i_a′] + a_grid[i_a′] - w * z_grid[i_z]) / (1 + r)
            end
            c_itp = linear_interpolation(as_endog, cs_endog,
                extrapolation_bc=Line())
            for i_a in 1:n_a
                if a_grid[i_a] <= as_endog[begin]  # constraint binds: a' = 0
                    c_new[i_a, i_z] = w * z_grid[i_z] + (1 + r) * a_grid[i_a]
                else
                    c_new[i_a, i_z] = c_itp(a_grid[i_a])
                end
            end
        end
        dist = maximum(abs.(c_new - c))
        c .= c_new
        dist < tol && break
    end
    # saving policy a' = cash on hand - c
    g = @. w * z_grid' + (1 + r) * a_grid - c
    return max.(g, a_grid[begin])  # enforce a' >= 0 (borrowing constraint)
end
定常分布の計算
家計の定常分布 \(\Lambda\) は, 資産グリッドと生産性グリッド上の確率質量 \(\lambda(a_i, z_k) = \Pr(a = a_i,\, z = z_k)\) (コードの λ) で表します. 分布関数を大文字, 確率質量を小文字で書き分けている点に注意してください.
EGM が返す \(a' = g(a, z)\) は資産グリッドの点とは限りません. 最近傍のグリッド点に丸めると質量が少数の点に集中して分布がギザギザになるので, lottery で \(a'\) を挟む2点に質量を按分します. 按分しても資産の平均は \(a'\) のまま保たれます. この按分の方法は非確率的シミュレーション (non-stochastic simulation) (Young 2010) とも呼ばれます.
按分の重みで アルゴリズム 3.3 の遷移行列 \(P\) を \((a, z)\) 上に作ると, 価値関数の復元が \(P \boldsymbol{V}\) だったのに対し, 定常分布は転置を掛けた \(\boldsymbol{\lambda} = P^\top \boldsymbol{\lambda}\) を満たします. \(P\) の各行の和は \(1\) なので \(I - P^\top\) は特異で, このままでは \(\boldsymbol{\lambda} = \boldsymbol{0}\) も解になります. そこで \((I - P^\top)\boldsymbol{\lambda} = \boldsymbol{0}\) のうち1本を正規化条件 \(\sum_i \lambda_i = 1\) に置き換え, 線形方程式として解きます. \(P\) は各行に非ゼロ要素が \(2 n_z\) 個しかないので, SparseArrays.jl の疎行列で持ちます.
using SparseArrays

function distribution(g, m)
    (; a_grid, Π, n_a, n_z) = m
    n = n_a * n_z
    state_index(i_a, i_z) = i_a + (i_z - 1) * n_a  # linear index for (a, z)
    rows, cols, vals = Int[], Int[], Float64[]
    for i_z in 1:n_z, i_a in 1:n_a
        # split a' between grid points
        j_lo, j_hi, ω = lottery(g[i_a, i_z], a_grid)
        for i_z′ in 1:n_z
            push!(rows, state_index(i_a, i_z), state_index(i_a, i_z))
            push!(cols, state_index(j_lo, i_z′), state_index(j_hi, i_z′))
            push!(vals, ω * Π[i_z, i_z′], (1 - ω) * Π[i_z, i_z′])
        end
    end
    P = sparse(rows, cols, vals, n, n)  # duplicate entries are summed

    # λ = Pᵀλ is singular; replace the first equation with sum(λ) = 1
    A = sparse(I - P')
    A[1, :] .= 1.0
    b = zeros(n)
    b[1] = 1.0
    return reshape(A \ b, n_a, n_z)
end

K_supply(λ, m) =
    sum(λ[i_a, i_z] * m.a_grid[i_a] for i_a in 1:m.n_a, i_z in 1:m.n_z)
一般均衡
与えられた \(r\) に対する超過需要 \(K^d(r) - K^s(r)\) を関数にまとめ, Bracketing method でゼロ点を求めます. 上限は完備市場の利子率 \(1/\beta - 1\) のすぐ手前に置きます.
function excess_demand(r, m)
    g = solve_household(r, m)
    λ = distribution(g, m)
    return K_demand(r, m) - K_supply(λ, m)
end

m_aiyagari = AiyagariModel()
r_star = find_zero(r -> excess_demand(r, m_aiyagari),
    (0.005, 1 / m_aiyagari.β - 1 - 1e-3), atol=1e-4)
r_complete = 1 / m_aiyagari.β - 1
K_star = K_demand(r_star, m_aiyagari)
@show r_star r_complete K_star;
r_star = 0.025369305928548195
r_complete = 0.04166666666666674
K_star = 6.819175158799509均衡利子率 \(r^* \approx 0.025\) は, 完備市場の値 \(1/\beta - 1 \approx 0.042\) を明確に下回っています. これが Aiyagari モデルの中心的な結果であり, 予備的貯蓄による過剰な資本蓄積を反映しています.
3.3.6 結果
貯蓄の政策関数
均衡 \(r^*\) における貯蓄の政策関数 \(a' = g(a, z)\) を生産性ごとに描きます. 低生産性の家計は手持ち資産を取り崩し (\(a' < a\)), 高生産性の家計は資産を積み増します. 借入制約 \(a' = 0\) が拘束するのは \(z_{\min}\) の家計の \(a \lesssim 0.03\) の範囲だけで, 資産の全域 (\(a \leq 50\)) に比べると非常に狭いため, 右のパネルで原点付近を拡大しています. 労働所得の下限 \(w z_{\min} \approx 0.37\) が正である限り, 無資産の家計でも消費を賄えるので, 制約が効く領域はこの程度に留まります.
Code
g = solve_household(r_star, m_aiyagari)

function policy_panel(xlim; legend=true)
    (; a_grid, n_z) = m_aiyagari
    p = plot(a_grid, g[:, 1], label=legend ? L"z_{\min}" : false, lw=2,
        xlabel=L"a", ylabel=L"a'")
    plot!(p, a_grid, g[:, n_z], label=legend ? L"z_{\max}" : false, lw=2)
    plot!(p, a_grid, a_grid, label=false, ls=:dash, color=:black, lw=1)
    plot!(p, xlims=(0, xlim), ylims=(0, xlim))
    return p
end

plot(policy_panel(20.0), policy_panel(0.3, legend=false),
layout=(1, 2), size=(700, 300))注: 破線は45度線 \(a' = a\). 右は原点付近の拡大.
資産の定常分布
定常分布を資産について周辺化すると, 富の分布が得られます. ヒストグラムにするときは集計の仕方に注意が必要です. 資産グリッドは原点付近を密にとっているので, 各グリッド点の質量を素朴に等間隔ビンへ足し込むと, ビンに入るグリッド点の数が場所によって 2 個や 3 個と変わり, 分布の性質ではない凹凸が出ます. そこで各グリッド点の質量を, その点が代表する区間 (隣接点との中点で区切った幅) とビンの重なりに応じて按分します. 借入制約上の質量は幅を持たない点質量なので, 最初のビンにそのまま入れます.
Code
g = solve_household(r_star, m_aiyagari)
masses_by_a = vec(sum(distribution(g, m_aiyagari), dims=2))

# split each grid point's cell across the equal-width bins it overlaps
(; a_grid, n_a) = m_aiyagari
cell_edges = vcat(a_grid[begin], (a_grid[1:(end-1)] .+ a_grid[2:end]) ./ 2,
    a_grid[end])
bin_edges = range(0, 30, length=61)
masses_by_bin = zeros(length(bin_edges) - 1)
masses_by_bin[begin] = masses_by_a[begin]        # atom at the constraint
for i_a in 2:n_a
    lo, hi = cell_edges[i_a], cell_edges[i_a+1]
    for i_bin in eachindex(masses_by_bin)
        overlap = min(hi, bin_edges[i_bin+1]) - max(lo, bin_edges[i_bin])
        overlap > 0 &&
            (masses_by_bin[i_bin] += masses_by_a[i_a] * overlap / (hi - lo))
    end
end

bin_centers = (bin_edges[1:(end-1)] .+ bin_edges[2:end]) ./ 2
bar(bin_centers, masses_by_bin, label=false, xlabel=L"a", ylabel="mass",
lw=0, color=1, bar_width=step(bin_edges), xlims=(-0.8, 30))注: 幅 \(0.5\) のビンに集計した資産の周辺分布. \(a = 0\) のビンの質量が借入制約に張り付く家計にあたる.
資本の需要と供給
最後に, Aiyagari モデルを象徴する図を描きます. 利子率 \(r\) の各値に対して資本供給 \(K^s(r)\) と資本需要 \(K^d(r)\) を計算し, 縦軸に \(r\), 横軸に資本をとります. 供給曲線は右上がりで \(r \to 1/\beta - 1\) の水平線に漸近し, 需要曲線は右下がりです. 両者の交点が均衡で, 完備市場の利子率より低い位置にあります. 完備市場では供給曲線が水平線 \(r = 1/\beta - 1\) そのものになるので, その均衡は \(K^d(r)\) と水平線の交点です.
Code
r_grid = range(-0.01, r_complete - 2e-3, length=40)
Ks_supply = [K_supply(distribution(solve_household(r, m_aiyagari),
    m_aiyagari), m_aiyagari)
             for r in r_grid]
# demand is defined for any r, so extend it past the complete-markets rate
r_grid_demand = range(-0.01, r_complete + 0.004, length=40)
Ks_demand = K_demand.(r_grid_demand, Ref(m_aiyagari))
K_complete = K_demand(r_complete, m_aiyagari)

visible = Ks_supply .<= 13.2     # both curves end at a similar capital level
xmax = 15.0

plot(Ks_supply[visible], r_grid[visible], label=false, lw=2,
    xlabel="capital", ylabel=L"r",
    xlims=(0, xmax), ylims=(-0.015, r_complete + 0.007))
plot!(Ks_demand, r_grid_demand, label=false, lw=2)
plot!([0, 13.6], [r_complete, r_complete], ls=:dash, color=:gray, lw=1,
    label=false)
scatter!([K_star], [r_star], label=false, color=mypalette[3])
scatter!([K_complete], [r_complete], label=false, color=:white,
    msc=mypalette[3])

# label each line at its right end instead of using a legend
annotate!(Ks_supply[visible][end] + 0.3, r_grid[visible][end],
    text(L"K^s(r)", :black, 9, :left))
annotate!(Ks_demand[begin] + 0.3, r_grid_demand[begin],
    text(L"K^d(r)", :black, 9, :left))
annotate!(13.9, r_complete, text(L"1/\beta - 1", :black, 9, :left))
annotate!(K_star - 0.4, r_star - 0.004, text(L"r^*", :black, 9, :left))注: 灰破線は完備市場の利子率 \(1/\beta - 1\). 黒点は不完備市場の均衡 \(\left(K^*, r^*\right)\), 白抜きの点は完備市場の均衡.
図 3.13 が示すように, 不完備市場では均衡利子率が完備市場の水準を下回り, それに伴って資本ストックが過剰に蓄積されます. これは, 個別リスクを保険できないことの帰結として生じる, 効率性の損失と内生的な富の不平等を同時に表しています.
生産性 \(z\) ごとの定常状態は \(k^*(z) = \left(\frac{z \alpha}{1/\beta - 1 + \delta}\right)^{\frac{1}{1-\alpha}}\) です. ここでの設定では \(z \in [0.76, 1.32]\) に対して \(k^*(z) \in [3.6, 8.9]\) となり, グリッド \([1, 10]\) に収まります. とくに後述の PFI はオイラー方程式を解くため, グリッドが定常状態を含んでいることが重要です.↩︎
(range(0, 1, length=n_a)).^2のように \([0, 1]\) の等間隔点を二乗することで, 原点付近に点を集めたグリッドを作っています.↩︎