using ForwardDiff
using Plots
using LaTeXStrings
using LinearAlgebra
using Optim
using Interpolations
using SpecialFunctions
using Distributions
using QuantEcon
using PrettyTables
using QuasiMonteCarlo
using FastGaussQuadrature
using Roots

import Random
Random.seed!(1234)2 関数近似
Function Approximation
経済モデルの数値計算では, 価値関数や政策関数のように, 一般形が分からない関数を扱います. これらは有限個のグリッド点の上でしか値を持たなかったり, ブラックボックスとしてしか評価できなかったりします. 本章では, そうした関数を扱う4つの基本操作を学びます. グリッド上の値から関数全体を復元する補間 (interpolation), その導関数を数値的に求める数値微分 (numerical differentiation), 期待値などの積分を有限個の評価点で近似する数値積分 (numerical integration), そして連続な確率過程を有限状態で近似する離散化 (discretization) です. いずれも, 後の第3章をはじめ数値計算のあらゆる場面で使われます.
2.1 補間
未知なる関数 \(f(x)\) の一般形は分からないが, 具体的な \(x\) に関しては \(f(x)\) の値が計算できる, という状況を考えます. 例えば第3章の動的計画法では, 来期の資本 \(k'\) が一般にグリッド点に一致しないため, グリッド上で求めた価値関数や政策関数をグリッド外で評価する必要があります. ちょっと極端な例を考えてみましょう. 次の効用最大化問題を考えます. \[ \max_{n} \log c - v(n) \quad \text{s.t.} \quad c = w n. \] ここで, 労働供給の不効用 \(v(n) = \phi \log (n!)\) とします. この時の最適な \(n^*\) を求めてみましょう.
v(n::Int; ϕ=0.1) = ϕ * sum(log(i) for i in 1:n)
u(n::Int; w=1.0) = log(n) - v(n)
2.1.1 グリッドサーチ
最も単純な方法は, \(n = 1, \dots, 10\) ぐらいまで試してみて, 最も効用 \(u(c, n)\) が大きくなる \(n\) を選ぶ方法です. これをグリッドサーチと呼びます. 後の第3章で扱う Value Function Iteration も, 本質的にはこのグリッドサーチを価値関数の最大化に用いています.
Code
scatter(1:10, u, label=false, xlabel=L"n", ylabel=L"u(c, n)")argmax(u, 1:10)62.1.2 区分線形補間と3次スプライン補間
これを実数の世界に拡張してみましょう. もし, \(n\) が実数の時の \(v(n)\) の値が計算できれば, 通常の一変数関数の最大化問題として解くことができます. そのために, \(v(n)\) を補間 (interpolation) してみましょう. Juliaでは Interpolations.jl パッケージを用います.
n_grid = 1:10
v_grid = v.(n_grid)
v_interp = linear_interpolation(n_grid, v_grid)
v_spline = Interpolations.scale(
    interpolate(v_grid, BSpline(Cubic(Line(OnGrid())))),
    n_grid
)
Code
scatter(1:10, v, label="Grid Points", xlabel=L"n", ylabel=L"v(n)")
plot!(1:0.1:10, n -> v_interp(n), label="Linear Interpolation", legend=:topleft)
plot!(1:0.1:10, n -> v_spline(n), label="Cubic Spline", linestyle=:dash)ここでは線形補間 (linear interpolation) と3次スプライン補間 (cubic spline interpolation) の両方を定義しました. 線形補間は2点間を直線で結ぶだけですが, スプライン補間はより滑らかな曲線で補間します. スプライン補間がこの「滑らかさ」の意味で最良の補間となる理由はA.2節で証明します.
このように実数上に定義された関数を用いれば, 通常の最適化問題のように解くことができます.1
u_interp(n) = log(n) - v_interp(n)
u_spline(n) = log(n) - v_spline(n)

sol_interp = optimize(n -> -u_interp(n), 1.0, 10.0)
sol_spline = optimize(n -> -u_spline(n), 1.0, 10.0)

println("Linear Interpolation: n = $(round(sol_interp.minimizer, digits=4))")
println("Cubic Spline: n = $(round(sol_spline.minimizer, digits=4))")
Linear Interpolation: n = 5.5811
Cubic Spline: n = 5.5516今回の例では, 階乗はガンマ関数 を用いて実数に拡張できるので, より厳密な解を求めることもできます.
Code
v(n::Real; ϕ=0.1) = ϕ * loggamma(n + 1)
u_exact(n) = log(n) - v(n)
sol_exact = optimize(n -> -u_exact(n), 1.0, 10.0)
println("Exact Solution: n = $(round(sol_exact.minimizer, digits=4))")
Exact Solution: n = 5.55122.2 数値微分
補間がグリッド上の値から関数そのものを復元するのに対し, ここではその導関数を数値的に求めます. 第1章では, ニュートン法がヤコビアンを, 準ニュートン法が勾配やヘッセ行列を用いました. 解析的に導関数が求まればそれを渡すのが最も高速で正確ですが, 関数が複雑で微分が面倒な場合や, ブラックボックスとして与えられる場合には, 導関数を数値的に求める必要があります. ここでは有限差分から始め, その弱点を複素ステップ微分と自動微分がどう克服するかを見ていきます.
2.2.1 有限差分
微分の定義 \(f'(x) = \lim_{h \to 0} \frac{f(x+h) - f(x)}{h}\) の極限を, 有限の \(h > 0\) で打ち切ったものが有限差分 (finite difference) です.
定義 2.1 (有限差分) 十分小さい \(h > 0\) に対して, 導関数を次のように近似する. \[ \begin{aligned} \text{Forward:} \quad f'(x) &\approx \frac{f(x+h) - f(x)}{h},\\ \text{Central:} \quad f'(x) &\approx \frac{f(x+h) - f(x-h)}{2h}. \end{aligned} \]
近似の精度はテイラー展開から分かります. \[ f(x \pm h) = f(x) \pm h f'(x) + \frac{h^2}{2} f''(x) \pm \frac{h^3}{6} f'''(x) + \cdots \] を代入すると, \[ \begin{aligned} \frac{f(x+h) - f(x)}{h} &= f'(x) + \frac{h}{2} f''(x) + O(h^2), \\ \frac{f(x+h) - f(x-h)}{2h} &= f'(x) + \frac{h^2}{6} f'''(x) + O(h^4) \end{aligned} \] となり, 前進差分の打ち切り誤差は \(O(h)\), 中心差分では2次の項が打ち消し合って \(O(h^2)\) です. したがって中心差分の方が高精度です.
刻み幅のトレードオフ. それならば \(h\) を限りなく小さくすればよいかというと, そうではありません. \(h\) を小さくすると打ち切り誤差は減りますが, 分子が非常に近い2数の差になるため桁落ち (subtractive cancellation) が起き, 丸め誤差が増大します. この丸め誤差と打ち切り誤差のトレードオフにより, 誤差は \(h\) の大きさによって下に凸な形を描き, 最適な \(h\) の大きさが存在します.
実際に \(f(x) = e^x\) の \(x = 0.5\) での微分 (\(f'(0.5) = e^{0.5}\)) を, 刻み幅 \(h\) を変えて計算してみましょう.
Code
f(x) = exp(x)
df_exact = exp(0.5)
x0 = 0.5
hs = 10.0 .^ range(-16, -1, length=61)

err_fwd = [abs((f(x0 + h) - f(x0)) / h - df_exact) for h in hs]
err_ctr = [abs((f(x0 + h) - f(x0 - h)) / (2h) - df_exact) for h in hs]
err_cpx = [max(abs(imag(f(x0 + im * h)) / h - df_exact), 1e-17) for h in hs]

plot(hs, err_fwd, xscale=:log10, yscale=:log10, lw=2,
    label="Forward diff.", xlabel=L"h", ylabel="absolute error", legend=:bottomright)
plot!(hs, err_ctr, lw=2, label="Central diff.")
plot!(hs, err_cpx, lw=2, label="Complex step")
図 2.3 の前進差分と中心差分はいずれも V 字(対数軸では下に凸)を描きます. 右側では打ち切り誤差が, 左側では桁落ちによる丸め誤差が支配的です. 中心差分の谷の方が前進差分より低く, かつ左寄りにあり, 精度が高いことが分かります.
2.2.2 複素ステップ微分
有限差分の弱点は, 分子の引き算で生じる桁落ちでした. これを回避するのが複素ステップ微分 (complex-step differentiation) です. 実軸ではなく虚軸方向に微小変位を与えます.
\(f\) が複素解析的なとき, \(f(x + ih)\) をテイラー展開すると \[ f(x + ih) = f(x) + ih f'(x) - \frac{h^2}{2} f''(x) - i\frac{h^3}{6} f'''(x) + \cdots \] なので, 虚部をとって \(h\) で割ると導関数が得られます. \[ f'(x) \approx \frac{\operatorname{Im}\left(f(x + ih)\right)}{h}, \qquad \text{error } O(h^2). \] この式には近い2数の引き算が現れないため桁落ちが起きず, \(h\) を \(10^{-200}\) のように極端に小さくしても丸め誤差が増えません. 図 2.3 の複素ステップの線が, \(h\) を小さくしても機械精度 (\(\approx 10^{-16}\)) のまま平坦であることがそれを示しています.
h = 1e-200
imag(f(x0 + im * h)) / h - df_exact0.0ただし複素ステップ微分が使えるのは, \(f\) が複素数に対しても解析的に評価できる場合に限られます. 絶対値や複素数向けに特別な分岐を持つ関数などには適用できません.
2.2.3 自動微分
有限差分も複素ステップも, あくまで微分の近似でした. 自動微分 (automatic differentiation, AD) は, プログラムが行う演算の連鎖に微分の連鎖律を適用し, 導関数を機械精度で厳密に求めます. 刻み幅 \(h\) を選ぶ必要もありません.
前進モードの AD は双対数 (dual number) \(x + \varepsilon\) (\(\varepsilon^2 = 0\)) を用います. 関数に双対数を通すと, テイラー展開の1次で打ち切られて \[
f(x + \varepsilon) = f(x) + f'(x)\, \varepsilon
\] となり, \(\varepsilon\) の係数として導関数がそのまま取り出せます. Julia では ForwardDiff.jl がこれを実装しています.
ForwardDiff.derivative(f, x0), df_exact(1.6487212707001282, 1.6487212707001282)有限差分の最良ケースでも誤差は \(10^{-8}\) 程度でしたが, 自動微分は厳密解と一致します. 多変数関数に対しては, 勾配やヘッセ行列も同様に求められます.
g(x) = x[1]^2 * sin(x[2]) + exp(x[1] * x[2])
ForwardDiff.gradient(g, [1.0, 2.0])
2-element Vector{Float64}:
16.596707051512663
6.972909262383508ForwardDiff.hessian(g, [1.0, 2.0])2×2 Matrix{Float64}:
31.3748 21.3349
21.3349 6.47976第1章で用いた Roots.jl, Optim.jl, NonlinearSolve.jl は, 内部でこの ForwardDiff.jl による自動微分を利用しています. 解析的な勾配を渡さなくても, これらのソルバーが機械精度の導関数を自動で計算してくれるため, 多くの場合はそのまま高速・高精度に解くことができます.
2.3 数値積分
以下の定積分を \(n\) 個の区間に分割して近似的に計算することを考えます. \[ \int_{a}^{b} f(x) \,dx \simeq \sum_{i=1}^{n} w_i f(x_i) \] ここで, \(w_i\) は各区間の重み, \(x_i\) は各区間の評価点です. この形の積分計算はいくつか方法がありますが, 最も基本的な台形則から紹介します.
2.3.1 台形則 (Trapezoidal Rule)
アルゴリズム 2.1 (台形則 (Trapezoidal Rule))
- 区間 \([a, b]\) を \(n\) 個の等間隔の区間に分割する. つまり, \(x_i = a + i \cdot \frac{b - a}{n}\) とする.
- 各区間を台形で近似する. よって近似式は以下のようになる. \[ \int_{a}^{b} f(x) \,dx \simeq \sum_{i=1}^{n} (x_i - x_{i-1}) \frac{f(x_{i-1}) + f(x_i)}{2} \]
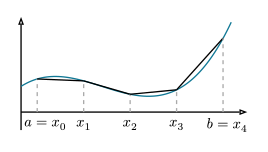
ここでは, \(f(x) = \sqrt{1 - x^2}\) の \([0, 1]\) での積分を計算してみましょう. 単位円の1/4の面積であるため, 解析解は \(\pi / 4\) です.
function trapezoid_rule(f, a, b, n)
    xs = range(a, b, length=n)
    return sum((xs[i] - xs[i-1]) * (f(xs[i-1]) + f(xs[i])) / 2 for i in 2:n)
end

sol_tr100 = trapezoid_rule(x -> sqrt(1 - x^2), 0.0, 1.0, 100)
sol_tr1000 = trapezoid_rule(x -> sqrt(1 - x^2), 0.0, 1.0, 1000)

π / 4, sol_tr100, sol_tr1000
(0.7853981633974483, 0.7850997945286542, 0.7853888527655861)100個の評価点で少数第三位まで, 1000個の評価点で少数第四位までの精度が得られていることがわかります.
ここで, 式 1.1 によって意思決定する人々の時間給 \(w\) が次のような分布に従っているとします. \[ \log w \sim \mathcal{N}(\mu, \sigma). \] この時, 平均労働時間を積分によって求めてみましょう. \[ \overline{h} = \int_{0}^{\infty} h^*(w) \,dF(w; \mu, \sigma). \] ここで, \(h^*(w)\) は時給 \(w\) の下での最適労働時間, \(F(w; \mu, \sigma)\) は \(w\) の累積分布関数です. 以下では, この積分をモンテカルロ法とガウス求積の2つの方法で計算します.
2.3.2 モンテカルロ法
定義 2.2 (モンテカルロ法 (Monte Carlo Method)) 確率変数 \(X \sim F\) に対する期待値 \[ \mathbb{E}[f(X)] = \int f(x) \,dF(x) \] を, \(F\) から独立に抽出した \(n\) 個のサンプル \(x_1, \dots, x_n\) を用いて \[ \mathbb{E}[f(X)] \simeq \frac{1}{n} \sum_{i=1}^{n} f(x_i), \quad x_i \overset{\text{i.i.d.}}{\sim} F \] と近似する. 大数の法則により, \(n \to \infty\) で真の値に収束する. 収束レートは \(O(n^{-1/2})\) である.
期待値を求める積分の場合, モンテカルロ法による近似も有効です. 速度は遅いですが, 実装が簡単であり, ガウス求積などの方法による積分の検算などにも利用できます.
mc_hours(; γ_c=1.5, α_l=1.2, γ_l=1.5, μ=0.0, σ=0.5, n=10^6) = mean(
    hours_worked(rand(LogNormal(μ, σ)), γ_c=γ_c, α_l=α_l, γ_l=γ_l)
    for _ in 1:n
)

mc_hours()0.46987292630609967準モンテカルロ法
定義 2.3 (準モンテカルロ法 (Quasi-Monte Carlo Method)) モンテカルロ法では擬似乱数を用いるのに対し, 準モンテカルロ法では低食い違い量列 (low-discrepancy sequence) と呼ばれる決定的な点列を用いる. 代表的な低食い違い量列として, Halton 列, Sobol 列, Niederreiter 列などがある.
一様分布 \(U[0, 1]\) 上の積分 \[ \int_0^1 f(x) \,dx \simeq \frac{1}{n} \sum_{i=1}^{n} f(x_i) \] において, \(x_1, \dots, x_n\) を低食い違い量列とすると, 収束レートは \(O(n^{-1} (\log n)^d)\) (\(d\) は次元) となり, 通常のモンテカルロ法の \(O(n^{-1/2})\) より高速に収束する.
低食い違い量列は空間をより均等に埋めるため, 同じサンプル数でもモンテカルロ法より精度の高い近似が得られます. 特に低次元の積分で効果的です. 図 2.5 は, 単位正方形上の256点を擬似乱数と Sobol 列で比較したものです.
Code
n_pts = 256
u_mc = rand(2, n_pts)
u_qmc = QuasiMonteCarlo.sample(n_pts, zeros(2), ones(2), SobolSample())
qmc_panels = map([("Pseudo-random", u_mc), ("Sobol sequence", u_qmc)]) do (t, u)
    scatter(u[1, :], u[2, :], ms=2.5, msw=0, label=false, title=t,
        xlabel=L"u_1", ylabel=L"u_2", aspect_ratio=1,
        xlims=(0, 1), ylims=(0, 1))
end
plot(qmc_panels..., layout=(1, 2), size=(640, 330))擬似乱数は各点を独立に引くため, 偶然の塊と空白ができます. これが分散, ひいては \(O(n^{-1/2})\) という遅い収束の源です. 一方 Sobol 列は既存の点が埋めていない場所に次の点を置くように設計された決定的な列で, 同じ256点でも空間をほぼ均等に覆っていることが分かります.
ここでは, 逆関数法を用いて, \([0, 1]\) 上の一様分布の低食い違い量列から対数正規分布のサンプルを生成します. すなわち, \(u_i\) を低食い違い量列の点とすると, \(w_i = F^{-1}(u_i; \mu, \sigma)\) として対数正規分布に従うサンプルを得ます.
ここでは QuasiMonteCarlo.jl パッケージを利用して Sobol 列を生成します.
function qmc_hours(; γ_c=1.5, α_l=1.2, γ_l=1.5, μ=0.0, σ=0.5, n=10^4)
    u = QuasiMonteCarlo.sample(n, 0, 1, SobolSample())
    ws = quantile.(LogNormal(μ, σ), u)
    return mean(hours_worked(w, γ_c=γ_c, α_l=α_l, γ_l=γ_l) for w in ws)
end

qmc_hours()0.46986726169921905モンテカルロ法では \(10^6\) 個のサンプルを用いているのに対し, 準モンテカルロ法では \(10^4\) 個のサンプルで同等以上の精度が得られていることがわかります.
2.3.3 ガウス求積 (Gaussian Quadrature)
命題 2.1 (ガウス求積 (Gaussian Quadrature)) \(n\) 次のルジャンドル多項式 \(P_n(x)\) の零点を \(x_1, \dots, x_n\) とし, \(L_i(x) = \prod_{j \neq i} (x - x_j)\), \(w_i = \int_{-1}^{1} \frac{L_i(x)}{L_i(x_i)} \,dx\) とすると, \[ \int_{-1}^{1} f(x) \,dx = \sum_{i=1}^{n} w_i f(x_i) \] が任意の \(2n-1\) 次の多項式 \(f(x)\) において成り立つ.
この方法は近似値ではなく, \(2n-1\) 次の多項式に対して厳密な値を計算することができるという点で強力です. また, \(f(x)\) が \(2n-1\) 次の多項式で十分近似できる場合, 精度の高い計算が可能です.
注意 (定義域の変換 (ガウス求積)). FastGaussQuadrature.jl 等のパッケージを利用する際には, 定義域を \([-1, 1]\) に変換する必要がある. \(x = \frac{b-a}{2} z + \frac{a+b}{2}\) と変換すると \[
\int_{a}^b f(x) \,dx = \frac{b - a}{2} \int_{-1}^1 f\left(\frac{b - a}{2} z + \frac{a + b}{2}\right) \,dz
\] を得られる.
function gaussian_quadrature(f, a, b, n)
    z, w = gausslegendre(n)
    return (b - a) / 2 * sum(w .* f.((b - a) / 2 * z .+ (a + b) / 2))
end

sol_gl10 = gaussian_quadrature(x -> sqrt(1 - x^2), 0.0, 1.0, 10)
sol_gl100 = gaussian_quadrature(x -> sqrt(1 - x^2), 0.0, 1.0, 100)

π / 4, sol_gl10, sol_gl100
(0.7853981633974483, 0.7855247925013235, 0.7853983068468604)10個程度の評価点で少数第三位まで, 100個程度の評価点で少数第六位までの精度が得られていることがわかります.
ガウスエルミート求積
ガウス求積は上に挙げたガウス・ルジャンドル求積の他にも, ガウス・エルミート求積などの類似系があります.
定義 2.4 (ガウス・エルミート求積 (Gaussian-Hermite Quadrature)) \(n\) 次のエルミート多項式 \(H_n(x)\) の零点を \(x_1, \dots, x_n\) とし, \(w_i = \frac{2^{n-1} n! \sqrt{\pi}}{\left(n H_{n-1}(x_i)\right)^2}\) とすると, \[ \int_{-\infty}^{\infty} f(x) e^{-x^2} \,dx \simeq \sum_{i=1}^{n} w_i f(x_i) \]
被積分関数が \(e^{-x^2}\) という部分を持つ場合により高精度に計算することができます. 具体的には, 正規分布に基づく積分の計算などに利用可能です. \(F(w; \mu, \sigma)\) が対数正規分布であることを利用して, ガウス・エルミート求積を用いて平均労働時間を計算します. \[ \begin{aligned} \overline{h} &= \int_{-\infty}^{\infty} h^*(\exp(y)) \,d\Phi(y; \mu, \sigma) \\ &= \int_{-\infty}^{\infty} h^*(\exp(y)) \frac{1}{\sqrt{2\pi} \sigma} \exp\left(-\frac{(y - \mu)^2}{2\sigma^2}\right) \,dy \\ &=\int_{-\infty}^{\infty} h^*\left(\exp\left(\sqrt{2}\sigma z + \mu\right)\right) \frac{1}{\sqrt{\pi}} \exp\left(-z^2\right) \,dz \\ &\simeq \sum_{i=1}^{n} w_i h^*\left(\exp\left(\sqrt{2}\sigma x_i + \mu\right)\right) \frac{1}{\sqrt{\pi}}. \end{aligned} \tag{2.1}\] ここでは \(w = \exp(y)\), \(y = \sqrt{2}\sigma z + \mu\) としました.
function mean_hours(; γ_c=1.5, α_l=1.2, γ_l=1.5, μ=0.0, σ=0.5, n=10)
    x, w = gausshermite(n)
    return sum(w .* hours_worked.(exp.(sqrt(2) * σ * x .+ μ), γ_c=γ_c, α_l=α_l, γ_l=γ_l) / sqrt(π))
end

mean_hours()0.46985756896625582.4 AR(1) 過程の離散化
補間と数値微分は「グリッド上の値しか持たない関数」を扱う道具でした. 動的計画法 (第3章) ではもう1つ, 「連続な値をとる確率過程」を有限個の状態で近似する操作が必要になります. 生産性や所得のショックは AR(1) のような連続状態の過程でモデル化されますが, ベルマン方程式の期待値を計算するには, これを有限状態のマルコフ連鎖に置き換えるのが最も手軽だからです. 過程の分布としての性質 (平均・分散・持続性) をできるだけ保ったまま離散化する, これも関数近似の一種です.
以下では次のAR(1) 過程を考えます. \[ x_{t+1} = \mu + \rho x_t + \varepsilon_{t+1}, \quad \varepsilon_{t+1} \sim \mathcal{N}(0, \sigma^2). \] \(\mu\) は切片であって定常平均そのものではないことに注意してください. 定常平均は \(\mathbb{E}[x_t] = \mu / (1 - \rho)\), 定常分散は \(\sigma_x^2 = \sigma^2 / (1 - \rho^2)\) です.
これを \(n\) 個のグリッドポイント \(\{x_1, \dots, x_n\}\) におけるマルコフ過程として離散化することを考えます. すなわち, 以下のような遷移確率行列 \(\Pi\) を考えます. \[ \begin{pmatrix} x_{1, t+1} \\ \vdots \\ x_{n, t+1} \end{pmatrix} = \begin{pmatrix} \pi_{1, 1} & \cdots & \pi_{1, n} \\ \vdots & \ddots & \vdots \\ \pi_{n, 1} & \cdots & \pi_{n, n} \end{pmatrix} \begin{pmatrix} x_{1, t} \\ \vdots \\ x_{n, t} \end{pmatrix} \] ここで, \(\pi_{i, j} = \Pr(x_{t+1} = x_j \mid x_t = x_i)\) であり, \(\sum_{j=1}^{n} \pi_{i, j} = 1\) が成り立ちます.
2.4.1 Tauchen 法
アルゴリズム 2.2 (Tauchen Method)
- \(x\) の定義域 \([x_{\min}, x_{\max}]\) を \(n\) 個のグリッドポイントに分割する. 通常は定常平均 \(\mu / (1 - \rho)\) を中心に, 定常標準偏差 \(\sigma_x\) の \(3\) 倍程度の範囲を考える.
- グリッドポイント \(x_i\) から \(x_j\) に遷移する確率を以下のように定義する. \[ \begin{aligned} \pi_{i, 1} &= \Phi\left(\frac{x_1 + \frac{d}{2} - \mu - \rho x_i}{\sigma}\right) \\ \pi_{i, j} &= \Phi\left(\frac{x_j + \frac{d}{2} - \mu - \rho x_i}{\sigma}\right) - \Phi\left(\frac{x_{j} - \frac{d}{2} - \mu - \rho x_i}{\sigma}\right) \quad (2 \leq j \leq n-1) \\ \pi_{i, n} &= 1 - \Phi\left(\frac{x_{n} - \frac{d}{2} - \mu - \rho x_i}{\sigma}\right) \end{aligned} \]
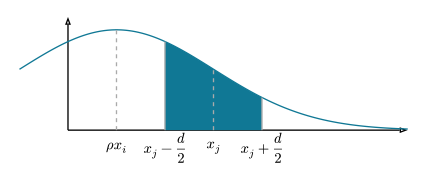
function tauchen_method(; n_std=3.0, n=5, ρ=0.9, μ=0.1, σ=1.0)

    x_mean = μ / (1 - ρ)
    x_min = x_mean - n_std * sqrt(σ^2 / (1 - ρ^2))
    x_max = x_mean + n_std * sqrt(σ^2 / (1 - ρ^2))
    x = range(x_min, x_max, length=n)

    d = (x_max - x_min) / (n - 1)
    Π = zeros(n, n)
    for i in 1:n
        Π[i, 1] = cdf(Normal(0.0, σ), x[1] + d / 2 - μ - ρ * x[i])
        Π[i, n] = 1 - cdf(Normal(0.0, σ), x[n] - d / 2 - μ - ρ * x[i])
        for j in 2:(n-1)
            Π[i, j] = cdf(Normal(0.0, σ), x[j] + d / 2 - μ - ρ * x[i]) -
                      cdf(Normal(0.0, σ), x[j] - d / 2 - μ - ρ * x[i])
        end
    end

    return x, Π
end

x, Π = tauchen_method()
@show x
Π
x = -5.8824720161168536:3.4412360080584268:7.88247201611685365×5 Matrix{Float64}:
0.849051 0.150945 3.84556e-6 1.22125e-15 0.0
0.0194737 0.896192 0.0843336 7.26002e-7 1.11022e-16
1.22258e-7 0.04266 0.91468 0.04266 1.22258e-7
7.34696e-17 7.26002e-7 0.0843336 0.896192 0.0194737
3.45903e-30 1.23783e-15 3.84556e-6 0.150945 0.849051実用上は QuantEcon.jl の tauchen 関数を利用するのがいいでしょう.
mc = tauchen(5, 0.9, 1.0, 0.1) # tauchen(N, ρ, σ, μ)
@show mc.state_values
mc.p
mc.state_values = -5.8824720161168536:3.4412360080584268:7.88247201611685365×5 Matrix{Float64}:
0.849051 0.150945 3.84556e-6 1.22125e-15 0.0
0.0194737 0.896192 0.0843336 7.26002e-7 1.11022e-16
1.22258e-7 0.04266 0.91468 0.04266 1.22258e-7
7.34696e-17 7.26002e-7 0.0843336 0.896192 0.0194737
3.45903e-30 1.23783e-15 3.84556e-6 0.150945 0.849051定常平均は \(\mathbb{E}[x_{t}] = \frac{\mu}{1-\rho}\) で, 上の例では \(\mu = 0.1\), \(\rho = 0.9\) としているため \(\mathbb{E}[x_{t}] = 1.0\) となります.
ps = vcat(stationary_distributions(mc)...)
ps' * collect(mc.state_values)1.02.4.2 Rouwenhorst 法
Tauchen 法は直感的で実装も簡単ですが, 2つの近似誤差を持ちます. 第一に, グリッドを \(\pm n_{std} \sigma_x\) で打ち切るため, 裾の確率質量が端の点に押し付けられます. 第二に, 離散化された連鎖の定常分散と自己相関は, 元の AR(1) のそれらと一致しません. このずれは持続性 \(\rho\) が高いほど, 状態数 \(n\) が少ないほど大きくなります. 代替となるのが Rouwenhorst 法です (Rouwenhorst (1995); 持続的な過程に対する優位性の分析は Kopecky and Suen (2010)).
アルゴリズム 2.3 (Rouwenhorst 法) AR(1) 過程 \(x_{t+1} = \rho x_t + \varepsilon_{t+1}\), \(\varepsilon \sim \mathcal{N}\left(0, \sigma^2\right)\) を \(n\) 状態で離散化する.
- グリッドは \(\left[-\psi, \psi\right]\) の等間隔 \(n\) 点とする. ただし \(\psi = \sigma \sqrt{\dfrac{n - 1}{1 - \rho^2}}\).
- \(p = \dfrac{1 + \rho}{2}\) とし, 遷移行列を次の再帰で構成する. \(n = 2\) のとき \[ \Pi_2 = \begin{pmatrix} p & 1 - p \\ 1 - p & p \end{pmatrix}. \] \(k = 3, \ldots, n\) について, \(\Pi_{k-1}\) を左上・右上・左下・右下に埋め込んだ4つの \(k \times k\) 行列の加重和 \[ \Pi_k = p \begin{pmatrix} \Pi_{k-1} & \mathbf{0} \\ \mathbf{0}' & 0 \end{pmatrix} + \left(1 - p\right) \begin{pmatrix} \mathbf{0} & \Pi_{k-1} \\ 0 & \mathbf{0}' \end{pmatrix} + \left(1 - p\right) \begin{pmatrix} \mathbf{0}' & 0 \\ \Pi_{k-1} & \mathbf{0} \end{pmatrix} + p \begin{pmatrix} 0 & \mathbf{0}' \\ \mathbf{0} & \Pi_{k-1} \end{pmatrix} \] を作り, 中間の行 (\(2, \ldots, k-1\) 行目) を \(2\) で割る.
この構成の見返りは, 打ち切りに頼らないことと, 連鎖の性質が厳密に分かることです.
命題 2.2 (Rouwenhorst 法の厳密性) Rouwenhorst 法で離散化された連鎖の定常分布は, 二項分布 \(B\left(n-1, 1/2\right)\) をグリッドに載せたものである. 定常平均・分散・1次自己相関は元の AR(1) の \(0\), \(\sigma_x^2 = \sigma^2 / \left(1 - \rho^2\right)\), \(\rho\) に厳密に一致し, さらに条件付き期待値も \(\mathbb{E}\left[x' \mid x\right] = \rho x\) と厳密に一致する. これらは状態数 \(n\) と持続性 \(\rho\) の値によらない (証明は Kopecky and Suen (2010) を参照).
function rouwenhorst_method(; n=5, ρ=0.9, σ=1.0)
    p = (1 + ρ) / 2
    Π = [p 1-p; 1-p p]
    for k in 3:n
        Πn = zeros(k, k)
        Πn[1:(k-1), 1:(k-1)] += p .* Π
        Πn[1:(k-1), 2:k] += (1 - p) .* Π
        Πn[2:k, 1:(k-1)] += (1 - p) .* Π
        Πn[2:k, 2:k] += p .* Π
        Πn[2:(k-1), :] ./= 2
        Π = Πn
    end
    ψ = σ * sqrt((n - 1) / (1 - ρ^2))
    x = collect(range(-ψ, ψ, length=n))
    return x, Π
end

x, Π = rouwenhorst_method()
@show x
Π
x = [-4.588314677411236, -2.294157338705618, 0.0, 2.294157338705618, 4.588314677411236]5×5 Matrix{Float64}:
0.814506 0.171475 0.0135375 0.000475 6.25e-6
0.0428688 0.821275 0.128963 0.006775 0.00011875
0.00225625 0.085975 0.823538 0.085975 0.00225625
0.00011875 0.006775 0.128963 0.821275 0.0428688
6.25e-6 0.000475 0.0135375 0.171475 0.814506こちらも実用上は QuantEcon.jl の rouwenhorst(N, ρ, σ) が使えます (上の実装と一致します). 2つの方法を, 離散化された連鎖の定常分布の標準偏差と1次自己相関で比べてみましょう. 真の値は \(\sigma_x = \sigma / \sqrt{1 - \rho^2}\) と \(\rho\) です.
Code
function chain_moments(x, Π)
    πs = vcat(stationary_distributions(MarkovChain(Π, x))...)
    m = dot(πs, x)
    v = dot(πs, (x .- m) .^ 2)
    Ex1x = sum(πs[i] * x[i] * dot(Π[i, :], x) for i in eachindex(x))
    return sqrt(v), (Ex1x - m^2) / v
end

rows = []
for ρ in (0.9, 0.99), n in (5, 7)
    sd_true = 1.0 / sqrt(1 - ρ^2)
    mc_t = tauchen(n, ρ, 1.0)
    sd_t, ac_t = chain_moments(collect(mc_t.state_values), mc_t.p)
    x_r, Π_r = rouwenhorst_method(n=n, ρ=ρ)
    sd_r, ac_r = chain_moments(x_r, Π_r)
    push!(rows, Any[ρ, n, round(sd_true, digits=2),
        round(sd_t, digits=2), round(ac_t, digits=3),
        round(sd_r, digits=2), round(ac_r, digits=3)])
end

pretty_table(permutedims(hcat(rows...));
    column_labels=[raw"$\rho$", raw"$n$", raw"$\sigma_x$ (true)",
        raw"$\hat\sigma_x$ (Tauchen)", raw"$\hat\rho$ (Tauchen)",
        raw"$\hat\sigma_x$ (Rouwenhorst)", raw"$\hat\rho$ (Rouwenhorst)"],
backend=:markdown, allow_markdown_in_cells=true)| \(\rho\) | \(n\) | \(\sigma_x\) (true) | \(\hat\sigma_x\) (Tauchen) | \(\hat\rho\) (Tauchen) | \(\hat\sigma_x\) (Rouwenhorst) | \(\hat\rho\) (Rouwenhorst) |
|---|---|---|---|---|---|---|
| 0.9 | 5 | 2.29 | 2.91 | 0.932 | 2.29 | 0.9 |
| 0.9 | 7 | 2.29 | 2.69 | 0.902 | 2.29 | 0.9 |
| 0.99 | 5 | 7.09 | 9.65 | 1.0 | 7.09 | 0.99 |
| 0.99 | 7 | 7.09 | 9.35 | 1.0 | 7.09 | 0.99 |
Tauchen 法は \(\rho = 0.9\) ですでに定常標準偏差を2〜3割過大にし, \(\rho = 0.99\) では自己相関がほぼ \(1\) に張り付いてしまいます. Rouwenhorst 法はどのケースでも厳密です.
Tauchen 法の退化. 図 2.7 は, 状態 \(x_4\) を条件とした \(x'\) の分布 \(\mathcal{N}\left(\rho x_4, \sigma^2\right)\) に, グリッド点と升目の境界を重ねたものです. Tauchen 法は, この条件付き分布の確率質量を升目ごとに拾って遷移確率にするのでした. 定常標準偏差 \(\sigma_x\) を固定したまま持続性を上げると, 条件付き分布の幅 \(\sigma = \sigma_x \sqrt{1 - \rho^2}\) はどんどん狭くなる一方, 升目の幅 \(d\) はグリッドの設定 (\(n\) と \(n_{std}\)) だけで決まって動きません. \(\rho = 0.99\) では分布がまるごと自分の升目に収まって \(\pi_{44} \approx 1\) となり, どの状態でも同じことが起きるため連鎖はほとんど動けなくなります. これが自己相関の張り付きの正体です. 逆に \(\rho\) が中程度でも, 升目が粗ければ「最寄りのグリッドに丸める」ことで余分な分散が毎期加わり, 定常分散が過大になります (表 2.1 の \(\hat\sigma_x\) の列). この退化の正確な主張と証明は Kopecky and Suen (2010) を参照してください.
Code
xg = range(-3, 3, length=5)                    # grid for σ_x = 1, n_std = 3
d = step(xg)
panels = []
for ρ in (0.5, 0.99)
    σε = sqrt(1 - ρ^2)
    m_cond = ρ * xg[4]                          # conditioning state x_4
    π44 = cdf(Normal(m_cond, σε), xg[4] + d / 2) - cdf(Normal(m_cond, σε), xg[4] - d / 2)
    xs = range(-4, 4, length=500)
    p = plot(xs, pdf.(Normal(m_cond, σε), xs), lw=1.5, label=false,
        title=L"\rho = %$ρ, \quad \pi_{44} = %$(round(π44, digits=2))",
        titlefontsize=10, xlabel=L"x'")
    vspan!(p, [xg[4] - d / 2, xg[4] + d / 2], color=mypalette[1], alpha=0.3, label=false)
    vline!(p, collect(xg), color=:gray, ls=:dot, label=false)
    scatter!(p, collect(xg), zeros(5), color=:black, ms=3, label=false)
    push!(panels, p)
end
plot(panels..., layout=(1, 2), size=(650, 250))持続性の高い過程を扱うとき, そしてデータから推定した \(\left(\rho, \sigma\right)\) をそのまま離散化に渡すとき (このとき離散化のずれは推定と数値解法の不整合として推定結果を歪めます) は, Rouwenhorst 法を使うのが安全です.
線形補間では一階微分までしかとれませんが, スプライン補間を用いれば二階微分が取れるので, derivative-based な最適化手法も使えます. ここでは1変数関数なので, bracketing method のような微分のいらない手法を用いています.↩︎